نُشر في 29 سبتمبر 2026. أسعار النماذج هي أسعار قوائم المزوّدين في ذلك التاريخ، مأخوذة من جدول الأسعار نفسه الذي تقوم عليه حاسبة الأرصدة في MakeInfluencer.ai. وتعرض المنصة التكلفة الدقيقة بالأرصدة قبل كل تشغيل.
تفشل معظم فيديوهات الذكاء الاصطناعي في الموضع نفسه. تكتب موجّهًا طويلًا وتنتظر التصيير، فتحصل على مقطع انحرف فيه الوجه وجاء التأطير خاطئًا وتغيّرت الإضاءة في منتصفه. ثم تعيد المحاولة، وكل إعادة تستهلك أرصدة فيديو، وهي أغلى أنواع الأرصدة.
حلّ صنّاع الأفلام هذه المشكلة قبل وجود النماذج التوليدية بزمن طويل. فهم يرسمون لوحة قصة: صورة ثابتة واحدة لكل لقطة، يُتفق عليها قبل أن يشغّل أحد الكاميرا. والانضباط نفسه يصلح لفيديو الذكاء الاصطناعي، وهو يعمل اليوم أفضل من أي وقت مضى، لأن هناك نموذجين متميزين لكل جزء من المهمة. فـ GPT Image 2.5 من OpenAI يرسم إطارات دقيقة متسقة الشخصية بتكلفة بضعة سنتات للإطار. وSeedance 2.5 من ByteDance يحرّك الإطار المعتمد إلى مقطع بصوت متزامن أصلي ويحافظ على ما ثبّته الإطار.
هذا الدليل هو النسخة الطويلة. يغطي كيفية كتابة قائمة لقطات يستطيع النموذج اتباعها، وكيفية إبقاء شخصية واحدة ثابتة عبر الإطارات، ومفردات الكاميرا التي تغيّر المخرجات فعلًا، وأنماط الموجّهات لكل نوع لقطة، ومثالًا متكاملًا من الفكرة الموجزة إلى أربعة مقاطع مكتملة بكل موجّهاتها، وتفصيل التكلفة بندًا بندًا، وسير عمل مسودات رخيصًا، ومقارنة صريحة مع مولدات لوحات القصة الأخرى. ويعرض الجزء الأخير النسخة بنقرة واحدة: قالب Storyboard to Film في AI Canvas.
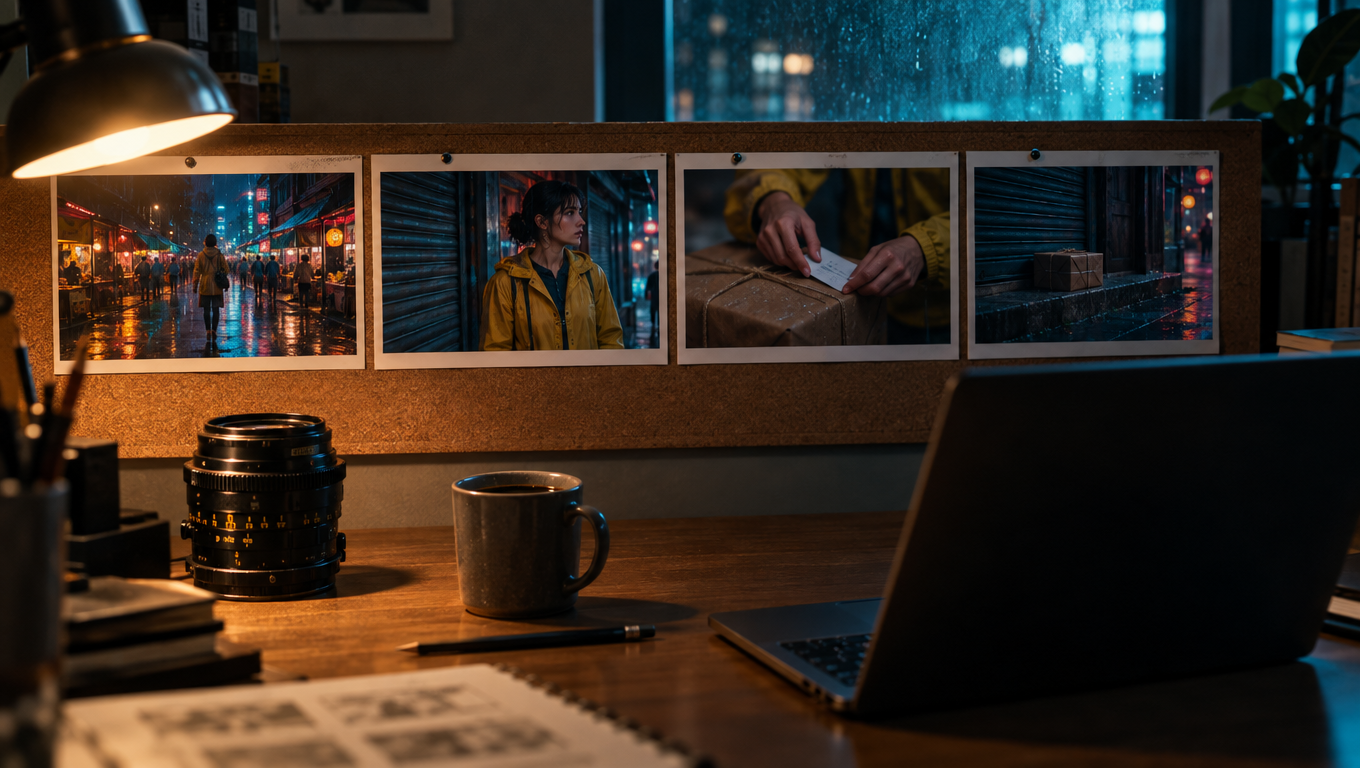
ما الذي يفعله مولد لوحة القصة بالذكاء الاصطناعي فعلًا
يحوّل مولد لوحة القصة بالذكاء الاصطناعي نصًا أو فكرة موجزة إلى سلسلة من الإطارات الثابتة، واحد لكل لقطة، لتراها وتوافق عليها قبل إنتاج الفيديو. وقد توقفت الأدوات الأقدم عند هذا الحد: رسوم توضيحية أو صور بأسلوب المكتبات الجاهزة لاجتماع مع عميل. أما الجيل الجديد من أدوات لوحات القصة فيضيف إلى الفيديو خطوة الإنتاج. فكل إطار معتمد يصبح الإطار الأول لمقطع فيديو، وبذلك لا تكون اللوحة خطة للفيلم، بل نصفه الأول.
وهذا التغيير مهم لأن نماذج الصور ونماذج الفيديو تخفق بطرق مختلفة. فنماذج الصور جيدة في التكوين والأزياء والوجوه والإضاءة، ورخيصة الإعادة. ونماذج الفيديو جيدة في الحركة والصوت، لكن حين تطلب منها أن تخترع التكوين أيضًا، فإنها تنفق قدرتها في التخمين، وتتراكم التخمينات الصغيرة على مدى خمس أو عشر ثوانٍ. وتقسم لوحة القصة المشكلة: نموذج الصور يقرر كيف تبدو اللقطة، ونموذج الفيديو يقرر فقط كيف تتحرك.
لماذا لوحة القصة أولًا
لوحة قصة الذكاء الاصطناعي هي موجز الإنتاج، وليست لوحة أجواء. فكل إطار يجيب عن سؤالين: ما الذي يجب أن يبقى ثابتًا (الشخصية والأزياء والمكان والإضاءة) وما الذي سيتحرك (فعل واحد، وحركة كاميرا واحدة). وحين يُعتمد الإطار، لا يبقى لنموذج الفيديو إلا القليل جدًا ليخترعه.
ويترتب على ذلك ثلاثة آثار عملية:
- تثبّت المظهر قبل أن تنفق أرصدة الفيديو. إطار GPT Image 2.5 Flare مع مرجع للشخصية، بدقة 1K وجودة متوسطة، يكلّف $0.039 بسعر القائمة. أما مقطع Seedance 2.5 Turbo مدته خمس ثوانٍ بدقة 720p فيكلّف $1.00. فالإطار أرخص بنحو 25 مرة، لذا كرّر هناك.
- المرجع نفسه يغذّي كل لقطة. صورة الشخصية المرجعية تدخل في كل إطار، فيبقى الوجه ثابتًا عبر التسلسل بدل أن ينحرف من لقطة إلى أخرى.
- تعيد إطارًا واحدًا أو مقطعًا واحدًا، لا التسلسل كله. إذا كانت اللقطة الثالثة خاطئة، فأعد اللقطة الثالثة وحدها.
النموذجان ولماذا يتكاملان
GPT Image 2.5 Flare (الإطارات)
نموذج الصور من OpenAI في سبتمبر 2026. أوضح من GPT Image 2 بنحو نصف زمن الاستجابة، وقوي في اتباع التأطير والتعليمات، ويقبل حتى 16 صورة مرجعية، وبذلك تبقى الشخصية متسقة. استغرق كل إطار نحو 27 ثانية في اختباراتنا.
Seedance 2.5 (المقاطع)
نموذج الفيديو الرائد من ByteDance، صدر في 31 يوليو 2026. يحرّك إطار البداية إلى مقطع مدته من 4 إلى 30 ثانية بصوت متزامن، ويحافظ على عنصر الإطار الرئيسي وأزيائه وإضاءته، ويتيح إطار نهاية اختياريًا. مستوى Turbo للمسودات، والمستوى القياسي للنسخ النهائية.
يأتي GPT Image 2.5 بنكهتين في MakeInfluencer.ai. Flare هو نموذج التوليد الذي يستخدمه القالب. وSunburst مضبوط للتعديلات الدقيقة التي تحافظ على الوجوه والمنتجات والتخطيطات، ما يجعله الأداة المناسبة حين تريد تغيير شيء واحد في إطار معتمد (تبديل لون السترة، أو تحريك الشخصية نحو اليسار) دون إعادة رسم الباقي.
ويأتي Seedance 2.5 أيضًا بمستويين. Seedance 2.5 Turbo يعمل بدقة 720p أو 1080p بسعر $0.20 أو $0.22 للثانية. وSeedance 2.5 القياسي يعمل من 480p إلى 4K ويكلّف $0.36 للثانية عند 720p. وكلاهما يأخذ الموجّه نفسه وإطار البداية نفسه، فنقل اللقطة من مسودة إلى نسخة نهائية هو تبديل نموذج وليس إعادة كتابة.
ويمكنك استبدال أي من النصفين. فـ Nano Banana Pro من Google نموذج إطارات قوي حين يكون ثبات الوجه عبر إطارات كثيرة أهم من دقة التكوين، وإن كان يكلّف $0.14 للإطار. وWan 3.0 من Alibaba هو أرخص طريقة للتحريك بدقة 720p، بسعر $0.10 للثانية. ويعتمد القالب افتراضيًا GPT Image 2.5 Flare وSeedance 2.5 Turbo لأن هذا الزوج يمنح أفضل دقة إطارات مقابل الدولار وأفضل حركة مقابل الدولار وقت كتابة هذا الدليل.
ملاحظة عن Sora 2
أوقفت OpenAI واجهة Sora 2 Videos API في 24 سبتمبر 2026. ولم تعد دروس لوحات القصة القديمة التي تحرّك الإطارات بـ Sora 2 تعمل عبر أي API. والخيارات العملية لتحريك إطارات لوحة القصة اليوم هي Seedance 2.5 وWan 3.0 وKling 3.0 وVeo 3.1 Fast.
كتابة قائمة اللقطات: الجزء الذي تتجاهله معظم لوحات القصة بالذكاء الاصطناعي
قبل تشغيل أي نموذج تحتاج إلى قائمة لقطات: المجموعة المرتبة من اللقطات، وما تُظهره كل منها، ولماذا توجد. ومعظم مقاطع الذكاء الاصطناعي القصيرة المخيبة للآمال ليست إخفاق نموذج، بل أربع صور جميلة بلا سبب يجعلها في هذا الترتيب.
بنية الإيقاعات الأربعة
يستخدم القالب بنية من أربعة إيقاعات مستعارة من الإعلانات القصيرة وتمارين مدارس السينما. وهي صغيرة بما يكفي لإنجازها في جلسة واحدة، ومكتملة بما يكفي لتبدو كقصة.
| اللقطة | مهمتها | التأطير | ما يتعلمه المشاهد |
|---|---|---|---|
| 1. التأسيس | إظهار العالم | واسع، عمق تركيز كبير، شخصية صغيرة إلى متوسطة في الإطار | أين نحن، وفي أي وقت، وما الحالة المزاجية |
| 2. الحركة | إظهار الحدث الرئيسي | متوسط، من الخصر إلى أعلى، فعل جسدي واضح واحد | ماذا تريد الشخصية وماذا تفعل |
| 3. اللقطة القريبة | إظهار الشعور | الوجه واليدان، عمق حقل ضحل | كيف تشعر الشخصية تجاه ما حدث |
| 4. الحل | إغلاق الدائرة | أوسع أو ثابت، يحمل لحظة سكون | أين تنتهي الشخصية؛ وكيف تحوّل المزاج |
والتدرج من الواسع إلى المتوسط إلى القريب ثم العودة إلى الخارج ليس زخرفة. فهكذا يبقي المونتيرون الجمهور متوجهًا منذ قرن. اللقطة الواسعة تخبر المشاهد أين هو. والقطع الأقرب يخبره بما يهم. واللقطة الأوسع في النهاية تمنحه مساحة ليشعر بالخاتمة. وإذا كسرت النمط فافعل ذلك عن قصد: قصة تبدأ بلقطة قريبة لليدين ولا تكشف الغرفة إلا في اللقطة الثانية قد تنجح، لكن فقط إذا كانت الفكرة الموجزة تتطلب ذلك.
فعل واحد لكل لقطة
المقطع الذي مدته خمس ثوانٍ يتسع لفعل واحد. «تلتفت وتمشي إلى الباب وتفتحه وتنظر إلى الخلف» أربعة أفعال، وسيخرج ضبابيًا متعجلًا أو مقطعًا يتوقف في منتصفه. أما «تدفع الباب بكتفها ليُفتح» فهو فعل واحد يستطيع نموذج الفيديو تحريكه بوضوح في خمس ثوانٍ. وإذا احتاجت قصتك إلى أكثر من ذلك، فهي تحتاج إلى لقطات أكثر، أو إلى مدة أطول لتلك اللقطة الواحدة.
اختبار مفيد: صف اللقطة لصديق بجملة واحدة تحتوي على فعل حركة واحد. وإن احتجت إلى كلمة «ثم»، فقسّمها.
قواعد الاستمرارية للكتابة
الاستمرارية هي ما يفعله رسام لوحات القصة البشري دون تفكير وما لا يفعله النموذج إطلاقًا. اكتب هذه القواعد مرة واحدة في الفكرة الموجزة، وسيحملها كاتب اللقطات إلى كل لقطة:
- الأزياء. سمِّ كل قطعة ملابس ظاهرة ولونها. «سترة مطر صفراء، وبنطال كارغو أسود، وحقيبة ساعٍ رمادية على الصدر».
- الوقت والطقس. «ليل، مطر خفيف، أرضية مبللة». إذا كانت تمطر في اللقطة الأولى وجافة في الثالثة، انهار التسلسل.
- مصدر الضوء. «لافتات النيون هي الضوء الرئيسي». وهذا يحافظ على ثبات لون الإضاءة.
- اتجاه الشاشة. إذا تحركت الشخصية من اليسار إلى اليمين في اللقطة الثانية، فلا ينبغي أن تأتي من اليمين في الرابعة إلا إذا استدارت. قل «تتحرك من اليسار إلى اليمين طوال الفيلم» إذا كان الاتجاه مهمًا.
- الأغراض. الطرد في اللقطة الثانية يجب أن يكون الطرد نفسه في الرابعة.
ما تتركه خارج الفكرة الموجزة
اترك الحوار، لأن الإطار لا يستطيع حمله ولأنه يغري نموذج الفيديو بحركة فم لن تطابق أي صوت. واترك النصوص المكتوبة على الشاشة وأسماء العلامات التجارية، لأن النص في الإطارات المولَّدة غير موثوق ولأن الشعارات تخلق مشكلات حقوق. واترك مصطلحات الكاميرا خارج الفكرة الموجزة نفسها: فكاتب اللقطات يضيف العدسة والإضاءة لكل لقطة، وفكرة موجزة تقول «anamorphic 35mm» ستدفع كل لقطة إلى التأطير نفسه.
اتساق الشخصية عبر الإطارات
الاتساق هو سبب استخدام سير عمل لوحة القصة أصلًا، لذا يستحق قسمًا خاصًا به. وهناك ثلاث طبقات، وتريدها كلها.
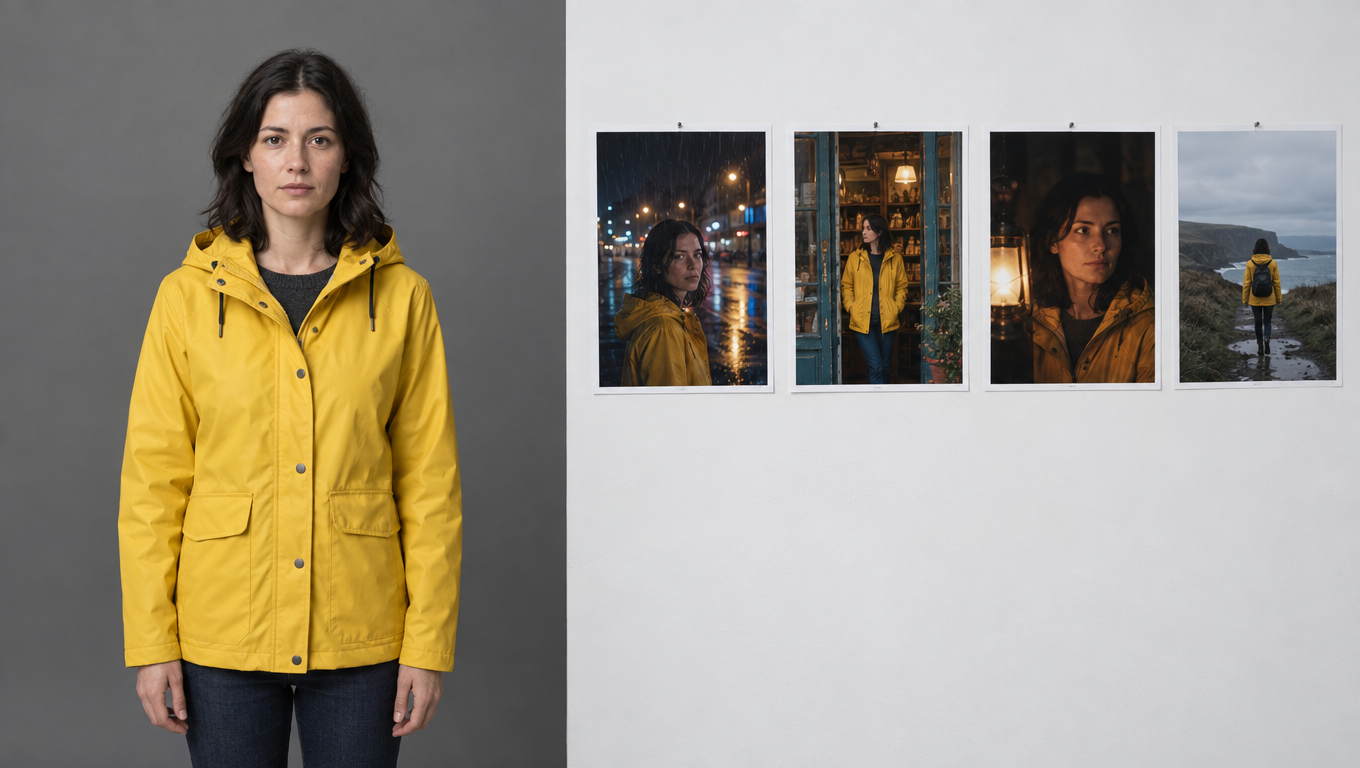
الطبقة الأولى: صورة مرجعية واحدة نظيفة
يحصل كل إطار على صورة الشخصية المرجعية نفسها. وينبغي أن تكون المرجعية صورة شخصية جيدة الإضاءة، من الأمام أو بزاوية ثلاثة أرباع، بوجه غير محجوب وتعبير محايد، ويُفضَّل أن تكون بالملابس التي تريدها في الفيلم. فصورة مرجعية بقميص أبيض تتصارع مع فكرة موجزة تطلب سترة صفراء؛ وسيضطر النموذج إلى اختيار أيهما يصدّق، ولن يقرر بالطريقة نفسها في كل مرة.
إذا كانت لديك شخصية ذكاء اصطناعي في MakeInfluencer.ai، فإن عقدة الشخصية تسحب الصورة المرجعية مباشرة. وإن لم تكن لديك، فارفع صورة شخصية نظيفة واحدة. ويغطي دليل إنشاء شخصية ذكاء اصطناعي متسقة كيفية صنع مرجع يصمد عبر مشاهد كثيرة، ويشرح دليل اتساق الشخصية المفاضلة بين الصور المرجعية والنماذج المدرَّبة.
الطبقة الثانية: تثبيت الهوية في الموجّه
المرجع وحده لا يكفي؛ فيجب أن يخبر الموجّه نموذج الصور بما ينبغي فعله به. وموجّه الإطار في القالب يقول في جملته الثانية: «الشخص في الصورة المرجعية هو الشخصية الرئيسية: أبقِ الوجه والشعر ولون البشرة والبنية مطابقة للمرجع». وهذا يجعل المرجع يعلو على أي شيء في وصف اللقطة، وهو ما تريده حين يصف كاتب اللقطات الشخصية وصفًا فضفاضًا.
الطبقة الثالثة: الإطار هو المرجع للمقطع
حين يحرّك Seedance 2.5 إطارًا، فالإطار هو الصورة الأولى. يبدأ النموذج من تلك البكسلات بالضبط، فأيًّا كانت الهوية التي يحملها الإطار، فالإطار الأول من المقطع يحملها كذلك. والانحراف داخل المقطع يأتي من الحركة: التفات رأس يكشف جانبًا لم يُظهره الإطار، أو لقطة قريبة تخترع تفاصيل. ويتصدى موجّه المقطع لذلك بعبارة «أبقِ الشخصية والأزياء والمكان والإضاءة تمامًا كما في الإطار» وبطلب حركة كاميرا واحدة لا ثلاث.
افحص الوجوه قبل التحريك
ضع الإطارات الأربعة جنبًا إلى جنب وانظر إلى الوجه فقط. فإذا كان وجه أحد الإطارات معطوبًا، فأعد توليد ذلك الإطار قبل تشغيل مقطعه. إصلاح وجه في إطار بـ $0.039 أرخص دائمًا من اكتشافه في مقطع بـ $1.00.
ما الذي ما زال يسير على نحو خاطئ
ليست العملية مثالية. وهذه الأخطاء التي سترى معظمها:
- اللقطات الجانبية للوجه. صورة مرجعية أمامية لا تخبر النموذج بشكل الوجه من الجانب. فإذا احتاجت لقطة إلى وجه جانبي، فأضف صورة مرجعية ثانية مأخوذة من الجانب.
- الوجوه الصغيرة جدًا. في اللقطة الواسعة قد يكون الوجه بطول 40 بكسل. فيقل ما يطابقه النموذج معه ويعتمد على التخمين أكثر. وهذا مقبول عادةً في اللقطات الواسعة؛ فالمشاهد يقرأ الهيئة العامة والملابس.
- اليدان والأغراض. اليدان اللتان تمسكان بالأشياء ما زالتا نقطة ضعف في نماذج الصور والفيديو معًا. أبقِ أفعال اليد بسيطة: الإمساك والوضع والدفع. وتجنب أي شيء يتطلب تفاعل الأصابع بدقة.
لغة الكاميرا التي تغيّر المخرجات
يفهم النموذجان مصطلحات السينما القياسية، لكن ليس لكل مصطلح أثر. وهذه هي المصطلحات التي تغيّر ما تحصل عليه بشكل موثوق.
مصطلحات التأطير (لنموذج الإطارات)
| المصطلح | ما يفعله GPT Image 2.5 به | استخدمه في |
|---|---|---|
| لقطة واسعة جدًا / لقطة تأسيسية واسعة | شخصية صغيرة، وبيئة مهيمنة | اللقطة 1 |
| لقطة كاملة | من الرأس إلى القدمين داخل الإطار | إظهار الأزياء والوقفة |
| لقطة متوسطة / من الخصر إلى أعلى | الجذع واليدان، ووجه مقروء | اللقطة 2، ومعظم الأفعال |
| لقطة متوسطة قريبة | من الصدر إلى أعلى | ردود الفعل مع بعض السياق |
| لقطة قريبة | الوجه يملأ معظم الإطار | اللقطة 3 |
| لقطة من فوق الكتف | كتف في المقدمة والعنصر الرئيسي خلفه | مشاهد الشخصيتين |
| زاوية منخفضة | الكاميرا تحت مستوى العين، فيبدو العنصر قويًا | لحظات القرار |
| زاوية مرتفعة | الكاميرا من الأعلى، فيبدو العنصر صغيرًا | العزلة والهزيمة |
وطول العدسة اختصار مفيد للمنظور. فـ «24mm» يمنحك عرضًا واسعًا مع كثير من البيئة. و«35mm» هو الخيار السردي الطبيعي. و«50mm» قريب من الرؤية البشرية. و«85mm» يضغط الخلفية ويعزل الوجه. والنموذج لا يحاكي البصريات بدقة، لكن هذه الأرقام تحرّك الإطار في الاتجاه الذي تتوقعه.
مصطلحات الحركة (لنموذج الفيديو)
| المصطلح | ما يفعله Seedance 2.5 به | يناسب |
|---|---|---|
| دفع بطيء إلى الأمام | الكاميرا تتحرك نحو العنصر الرئيسي | بناء التوتر والتركيز |
| سحب إلى الخلف / ابتعاد | الكاميرا تبتعد | النهايات والكشف |
| لقطة تتبّع | الكاميرا تتحرك مع العنصر الرئيسي | المشي والجري |
| بانوراما يمينًا أو يسارًا | الكاميرا تدور حول محورها | كشف مساحة |
| إمالة لأعلى أو لأسفل | الكاميرا تدور رأسيًا | كشف الارتفاع |
| كاميرا محمولة باليد | اهتزاز عضوي طفيف | الإلحاح والإحساس الوثائقي |
| ثابتة / مثبتة | لا حركة للكاميرا | ترك الفعل يحمل اللقطة |
| دوران حول العنصر | الكاميرا تدور حول العنصر الرئيسي | لحظات البطل، ونادرًا ما تُستخدم |
القاعدة الأنفع: حركة كاميرا واحدة لكل لقطة. فعبارة «دفع بطيء إلى الأمام مع بانوراما يسارًا وإمالة لأعلى» تطلب من النموذج حل ثلاث حركات في آن واحد، وسينجز عادةً واحدة منها بشكل سيئ. وإذا احتاجت لقطة إلى حركة معقدة، فربما ينبغي أن تكون لقطتين.
والقاعدة الثانية: طابق حركة الكاميرا مع مهمة اللقطة. لقطة التأسيس تريد بانوراما بطيئة أو دفعًا بطيئًا للأمام، فيمنح المشاهد وقتًا لقراءة المكان. ولقطة الحركة تريد تتبّعًا أو كاميرا محمولة. واللقطة القريبة تريد إما لا شيء أو دفعًا بطيئًا جدًا. ولقطة القرار تريد ابتعادًا أو إطارًا مثبتًا يترك اللحظة تتنفس.
أنماط الموجّهات بحسب نوع اللقطة
يبني القالب كل موجّه من جزأين: وصف اللقطة (يكتبه من جديد لكل لقطة نموذج لغوي بدور المخرج) والمواصفات الثابتة (المتطابقة في الإطارات الأربعة). في الحاوية يأتي وصف اللقطة أولًا، ثم سطر فارغ، ثم المواصفات. وإليك ما ينبغي أن يحتويه كل جزء، مع أنماط قابلة لإعادة الاستخدام.
مواصفات الإطار (ثابتة في كل الإطارات)
هذا هو النص بالضبط الذي يضيفه القالب إلى كل إطار:
Photoreal cinematic storyboard frame in 16:9. The person in the reference image is the lead character: keep face, hair, skin tone and build identical to the reference. Anamorphic feel on a 35mm lens, motivated natural light, fine film grain, muted graded palette. Compose the frame so it can be animated into a five-second shot. Avoid: on-screen text, captions, logos, watermarks, split screens, extra people, distorted hands.
جملتان تؤديان عملًا أكبر مما يبدو. عبارة «ركّب الإطار بحيث يمكن تحريكه» تبعد النموذج عن التركيبات المتجمدة المفرطة الإحكام وتقرّبه من إطارات فيها مساحة للحركة. وإدراج «الشاشات المقسمة» في قائمة التجنب يمنع GPT Image 2.5 أحيانًا من إعادة لوحة قصة متعددة الألواح في صورة واحدة، وهو إخفاق حقيقي حين تكون كلمة «لوحة قصة» في الموجّه.
مواصفات المقطع (ثابتة في كل المقاطع)
Animate this storyboard frame as the shot described above. Keep the character, wardrobe, set and lighting exactly as in the frame. One clear camera move, natural believable motion, ambient sound design that matches the scene, no music, no on-screen text.
عبارة «لا موسيقى» مقصودة. فأربعة مقاطع بأربعة أسرّة موسيقية مولَّدة مختلفة لا يمكن قصّها معًا. أما الصوت المحيطي (المطر وحركة المرور والخطوات وضجيج الغرفة) فيُقطع بسلاسة، ويمكنك وضع مسار موسيقي واحد فوق التسلسل المكتمل في أي محرر.
أنماط وصف اللقطة
ينبغي أن يتبع كل وصف للقطة الشكل نفسه المكوَّن من ثلاث جمل: ما نراه وأين الشخصية؛ ما تفعله الشخصية؛ التأطير والعدسة والإضاءة والمزاج. وهذه الأنماط تصلح نقاط بداية جيدة:
لقطة تأسيسية واسعة. «لقطة واسعة لـ [المكان] في [الوقت]، [الطقس]. [الشخصية] [صغيرة أو متوسطة] في الإطار، [فعل هادئ واحد يحدد النبرة]. عدسة 24mm، تركيز عميق، [مصدر الضوء] كضوء رئيسي، أجواء [المزاج]».
حركة متوسطة. «لقطة متوسطة من الخصر إلى أعلى لـ [الشخصية] وهي [فعل جسدي واحد] في [جزء من المكان]. [تفصيل واحد يُظهر النية أو المخاطر]. عدسة 35mm، [مصدر الضوء] من [الاتجاه]، مزاج [كلمة تعبّر عن الطاقة]».
لقطة قريبة عاطفية. «لقطة قريبة لـ [وجه الشخصية] ويديها مع [ردة الفعل أو الإدراك]. [تغيّر واحد في التعبير]. عدسة 85mm، عمق حقل ضحل، [إضاءة دافعة]، [المزاج]».
الحل. «[إطار أوسع أو ثابت] لـ [الشخصية] في [الوضعية النهائية أو الفعل] في [المكان]. [كيف تحوّلت البيئة أو الإضاءة منذ اللقطة الأولى]. [العدسة]، [الإضاءة]، وقد تحوّل المزاج إلى [المزاج الجديد]».
ويطلب موجّه النظام الذي يستخدمه القالب للمخرج من النموذج اللغوي أن يُخرج وصفًا بهذا الشكل فقط، دون عناوين أو قوائم أو تعليق، وألا يطلب أبدًا نصًا أو تعليقات توضيحية أو شعارات. ويمكنك تعديله في أي عقدة لكاتب اللقطات.
مثال متكامل: من فكرة موجزة إلى أربعة إطارات ثم أربعة مقاطع
هذا تشغيل كامل واحد بكل موجّهاته. ويستخدم الإعدادات الافتراضية للقالب: GPT Image 2.5 Flare بنسبة 16:9 ودقة 1K وجودة متوسطة للإطارات، وSeedance 2.5 Turbo بدقة 720p ومدة خمس ثوانٍ مع الصوت في المقاطع.
الفكرة الموجزة
هذا هو النص الوحيد الذي تكتبه:
Story: Mara, a 30-year-old courier, races the last delivery of the night through a rain-soaked market street and finds the shop already closed, then leaves the parcel on the step with a handwritten note tucked under the string. Setting: night market street, neon signage, light rain, wet cobblestones. Wardrobe: yellow rain jacket, black cargo trousers, grey courier bag across the chest. Tone: melancholic. Do not change the character's look between shots.
لماذا تنجح: شخصية واحدة، ومكان واحد، وقوس واحد له نهاية، وأزياء تُسمّى مرة واحدة، ونبرة تُسمّى مرة واحدة. أما الأفكار الموجزة التي تحتوي على ثلاثة أماكن أو شخصيتين رئيسيتين فتنتج لوحات منحرفة، لأن كل إطار يُولَّد بشكل مستقل والرابط الوحيد بينها هو النص والمرجع.
أوصاف اللقطات الأربع
تتلقى كل عقدة كاتب لقطات الفكرة الموجزة إضافةً إلى تعليمة الإيقاع. وعادةً ما يبدو الناتج هكذا (يعمل النموذج اللغوي بدرجة حرارة 0.8، لذا ستختلف الصياغة لديك):
اللقطة 1، التأسيس. «لقطة واسعة لشارع سوق ضيق ليلًا وقد لمع المطر، أكشاك مغلقة ولافتات نيون بالوردي والفيروزي تنعكس على الحجارة المبتلة. مارا بسترة مطر صفراء وحقيبة ساعٍ رمادية على صدرها، صغيرة في منتصف المسافة، تركض نحو الكاميرا بين الأكشاك. عدسة 24mm، تركيز عميق، النيون ضوء رئيسي، أجواء باردة كئيبة».
اللقطة 2، الحركة. «لقطة متوسطة من الخصر إلى أعلى لمارا وهي تتوقف فجأة أمام متجر صغير أُنزل بابه المعدني، ويدها الواحدة ما زالت تمسك بالطرد الورقي البني. يتجمع المطر على غطاء رأسها الأصفر ويظهر نَفَسها في الهواء البارد. عدسة 35mm، نيون فيروزي من اليسار، مزاج متوتر ومنكسر».
اللقطة 3، اللقطة القريبة. «لقطة قريبة لوجه مارا ويديها وهي تدسّ ملاحظة مطوية مكتوبة بخط اليد تحت خيط الطرد، ونظرتها مطرقة. ابتسامة صغيرة متعبة. عدسة 85mm، عمق حقل ضحل، توهج دافئ من فانوس قريب في مقابل نيون بارد، مزاج هادئ حنين».
اللقطة 4، الحل. «لقطة واسعة ثابتة من الجهة المقابلة للشارع: يجلس الطرد وحيدًا على درجات المتجر تحت مظلة صغيرة بينما تمشي مارا نحو اليمين، وسترتها الصفراء هي اللون الدافئ الوحيد في الإطار. خفّ المطر إلى رذاذ. عدسة 35mm، نيون وضوء فانوس، وقد تحوّل المزاج من الإلحاح إلى قبول هادئ».
لاحظ ما نقله النموذج اللغوي من الفكرة الموجزة دون أن يُقال له مرة أخرى: السترة الصفراء والحقيبة الرمادية والنيون والمطر. ولهذا تسمّيها الفكرة الموجزة مرة واحدة وبوضوح.
الإطارات الأربعة
تتلقى كل عقدة إطار وصف لقطتها، والمواصفات ملحقة بعد سطر فارغ، وصورة الشخصية المرجعية. والموجّه الكامل للإطار 2، كما أُرسل بالضبط، هو:
Medium shot, waist-up, of Mara stopping short in front of a small shop with its metal shutter pulled down, one hand still gripping the brown paper parcel. Rain beads on her yellow hood and her breath shows in the cold air. 35mm lens, teal neon from the left, tense and deflated mood.

Photoreal cinematic storyboard frame in 16:9. The person in the reference image is the lead character: keep face, hair, skin tone and build identical to the reference. Anamorphic feel on a 35mm lens, motivated natural light, fine film grain, muted graded palette. Compose the frame so it can be animated into a five-second shot. Avoid: on-screen text, captions, logos, watermarks, split screens, extra people, distorted hands.
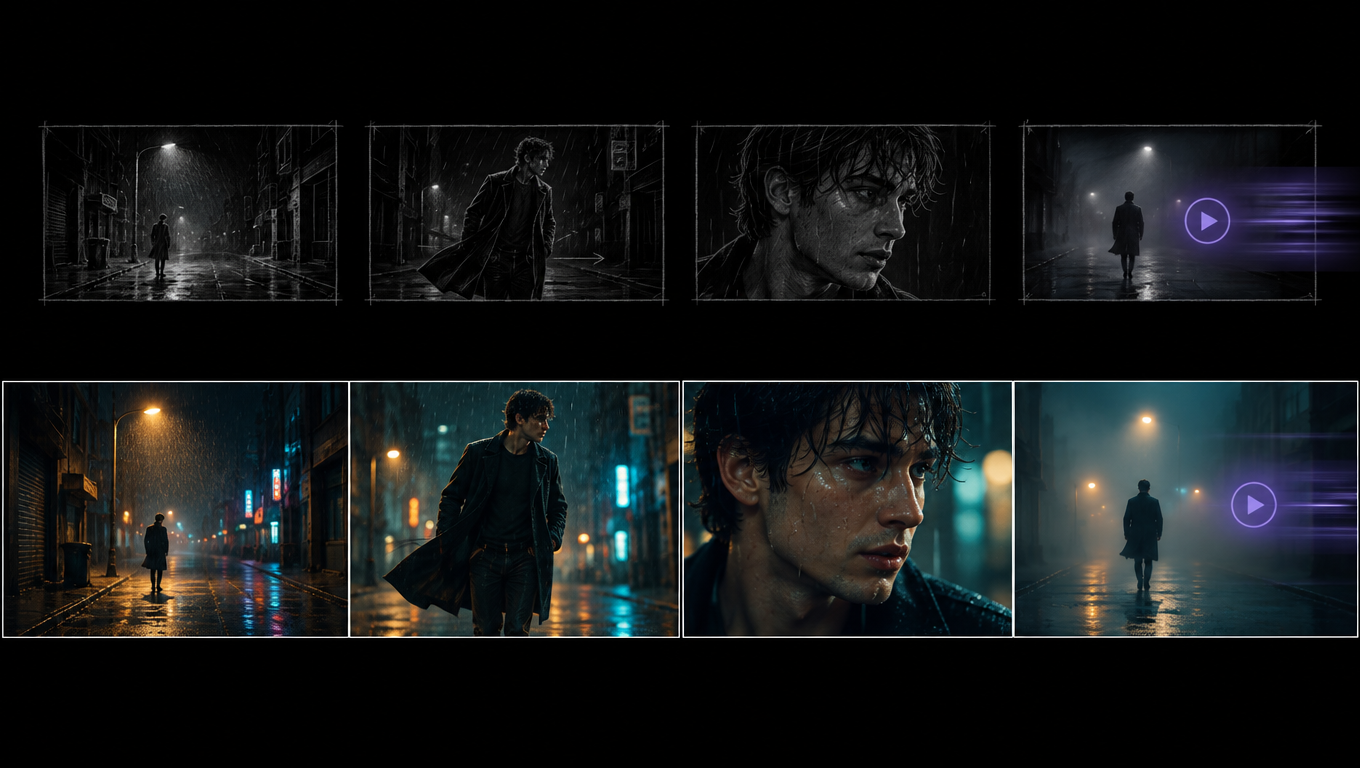
راجع الإطارات الأربعة بقائمة تحقق قصيرة قبل تشغيل أي مقطع:
- هل الوجه هو الشخص نفسه في جميع الإطارات؟
- هل الأزياء متطابقة، بما فيها الألوان؟
- هل مصدر الضوء متسق (نيون هنا، لا ضوء نهار)؟
- هل يُظهر كل إطار فعلًا واحدًا فقط، مع مساحة لتحريكه؟
- هل تسلل أي نص أو شعار أو شخص إضافي؟
وفي التشغيل المعتاد، يحتاج إطار واحد من كل أربعة إلى محاولة ثانية. والإصلاح الأكثر شيوعًا هو للقطة التأسيس الواسعة، حيث تكون الشخصية صغيرة ويضيف النموذج أحيانًا شخصيات زائدة في شارع السوق. أعد تشغيل عقدة ذلك الإطار وحده؛ أما الثلاثة الأخرى فتبقى كما هي.
المقاطع الأربعة
تتلقى كل عقدة مقطع الإطار بوصفه إطار البداية، ووصف اللقطة إضافةً إلى مواصفات المقطع بوصفها الموجّه. والموجّه الكامل للمقطع 2 هو:
Medium shot, waist-up, of Mara stopping short in front of a small shop with its metal shutter pulled down, one hand still gripping the brown paper parcel. Rain beads on her yellow hood and her breath shows in the cold air. 35mm lens, teal neon from the left, tense and deflated mood.

Animate this storyboard frame as the shot described above. Keep the character, wardrobe, set and lighting exactly as in the frame. One clear camera move, natural believable motion, ambient sound design that matches the scene, no music, no on-screen text.
وإذا أردت توجيه الحركة بدقة أكبر من «حركة كاميرا واضحة واحدة»، فأضف سطرًا واحدًا إلى موجّه عقدة المقطع المعنية. وفي هذا التسلسل:
| المقطع | سطر الحركة المضاف | السبب |
|---|---|---|
| 1 | "Slow push-in as she jogs toward camera, footsteps splashing." | يجذب المشاهد إلى الشارع |
| 2 | "Handheld, slight shake, she exhales and her shoulders drop." | الإلحاح ينهار إلى خيبة |
| 3 | "Locked off, only the hands and eyes move." | يترك الإيماءة الصغيرة تحمل اللقطة |
| 4 | "Slow pull-out while she walks out of frame to the right." | يترك الطرد وحيدًا في النهاية |
المقطع أعلاه تصيير حقيقي بـ Seedance 2.5 Turbo من صورة إلى فيديو لأحد إطارات القالب. أربعة مقاطع بالترتيب تصنع فيلمًا مدته 20 ثانية. اقصّها في أي محرر، وضع مسارًا موسيقيًا واحدًا تحتها، فتحصل على فيلم قصير بشخصية متسقة واحدة ومكان واحد وقوس مكتمل.
إصلاح مقطع سيئ
إذا ساء مقطع واحد، فشخّص المشكلة قبل إعادة المحاولة:
- انحراف الوجه في منتصف المقطع. يسببه عادةً التفات الرأس. أضف «تُبقي وجهها متجهًا نحو الكاميرا» أو اختر حركة كاميرا لا تكشف زاوية جديدة.
- يحدث الكثير جدًا. وصف اللقطة يحتوي على فعلين. قصّه إلى فعل واحد.
- لا يحدث شيء. الإطار مفرط في الثبات. أعد توليد الإطار بتكوين أكثر انفتاحًا، أو أضف سطر فعل صريحًا إلى المقطع.
- صوت خاطئ. سمِّ الصوت: «مطر على مظلة وحركة مرور بعيدة، بلا أصوات».
- المقطع أقصر من أن ينجح. ارفع مدة تلك العقدة إلى 8 أو 10 ثوانٍ. يقبل Seedance 2.5 من 4 إلى 30 ثانية.
ما تكلّفه العملية، بندًا بندًا
كل الأرقام أدناه هي أسعار قوائم المزوّدين من ملف أسعار MakeInfluencer.ai، جرى التحقق منها في 29 سبتمبر 2026. ويستخدم عمود الأرصدة تحويل المنصة الحالي؛ ويعرض زر التشغيل في Canvas التكلفة الإجمالية الدقيقة قبل أن يبدأ أي شيء.
| الخطوة | النموذج والإعدادات | العدد | سعر القائمة | الأرصدة التقريبية للواحد |
|---|---|---|---|---|
| كتابة اللقطات | Director LLM | 4 | جزء من السنت | 1,000 |
| الإطارات | GPT Image 2.5 Flare، 1K متوسط، مع مرجع الشخصية | 4 | $0.039 | 1,955 |
| المقاطع | Seedance 2.5 Turbo، 720p، 5 ثوانٍ، مع الصوت | 4 | $1.00 | 50,126 |
| الإجمالي لكل تشغيل | نحو $4.16 | نحو 212,000 |
وتستخدم الإطارات مع مرجع الشخصية تسعير تحرير GPT Image 2.5 ($0.039 عند 1K متوسط) بدل سعر النص إلى صورة العادي ($0.024)، لأن الصورة المرجعية مدخل. وكل مرجع إضافي بعد الأول يضيف $0.015.
والمقاطع تمثل 96 بالمئة من الفاتورة. وهذه هي الحجة الكاملة للموافقة على اللوحة أولًا.
مسارات الترقية والتخفيض
| التغيير | تكلفة المقطع الجديدة (5 ثوانٍ) | إجمالي أربعة مقاطع | متى يستحق |
|---|---|---|---|
| الافتراضي: Seedance 2.5 Turbo بدقة 720p | $1.00 | $4.00 | المسودات والنسخ الاجتماعية |
| Seedance 2.5 Turbo بدقة 1080p | $1.10 | $4.40 | النسخة النهائية لمعظم المنصات |
| Seedance 2.5 القياسي بدقة 720p | $1.80 | $7.20 | لقطات البطل ذات الحركة المعقدة |
| Seedance 2.5 القياسي بدقة 1080p | $4.50 | $18.00 | التسليمات للعملاء |
| Wan 3.0 بدقة 720p | $0.50 | $2.00 | التشغيلات الاقتصادية والحركة البسيطة |
| Kling 3.0 Pro مع الصوت | $0.84 | $3.36 | حين تفضّل أسلوب حركة Kling |
| Gemini Omni 1.1 Flash بدقة 360p | $0.15 | $0.60 | اختبارات الحركة فقط |
إعداد مختلط معقول: Turbo بدقة 720p للقطات 1 و3 و4، وSeedance 2.5 القياسي بدقة 720p للقطة الحركة. فيكون المجموع $4.80 للمقاطع، ويذهب الإنفاق الإضافي إلى حيث تكون الحركة الأصعب.
أما في جانب الإطارات، فرفع الجودة إلى «عالية» عند 1K يكلّف $0.105 للإطار مع المرجع، وهذا تافه مقارنةً بالمقاطع. استخدمه حين تخطط لاستخراج صورة ملصق ثابتة من أحد الإطارات.
سير عمل المسودات: اختبر الحركة بتكلفة زهيدة قبل الالتزام
Seedance 2.5 Turbo هو أصلًا المستوى الاقتصادي، لكن إن كنت تخطط لتكرار كثيف على لوحة، فهناك خطوة أولى أرخص. يولّد Gemini Omni 1.1 Flash من Google مقاطع من 3 إلى 10 ثوانٍ بدقة 360p بسعر $0.03 للثانية، فيكلّف اختبار حركة مدته خمس ثوانٍ $0.15، أي نحو 7,500 رصيد. وهو يدعم إطاري البداية والنهاية، والصوت فيه مفعّل دائمًا.
وسير العمل، الذي تبيعه بعض المنصات على أنه ميزة «وضع المسودة»، ثلاث تمريرات فقط:
تمريرة الإطارات
شغّل الفكرة الموجزة وكتّاب اللقطات والإطارات فقط. وافق على الإطارات الأربعة. التكلفة: نحو $0.16 بسعر القائمة.
تمريرة الحركة بدقة 360p
اضبط كل عقدة مقطع على Gemini Omni 1.1 Flash بدقة 360p ومدة خمس ثوانٍ. راقب حركات الكاميرا التي تكشف زوايا سيئة، والأفعال التي لا تتسع لها المدة، والتوقيت. عدّل أسطر الحركة. التكلفة: $0.60 لأربعة مقاطع.
التمريرة النهائية
أعد عقد المقاطع إلى Seedance 2.5 Turbo بدقة 720p أو 1080p، أو إلى Seedance 2.5 القياسي للقطة البطل، وشغّل. التكلفة: من $4.00 إلى $7.20 بحسب المزيج.
والتحذير صريح: مسودة بدقة 360p من نموذج مختلف تخبرك عن التكوين والتوقيت والحركة، ولا تخبرك بدقة كيف سيرسم Seedance 2.5 الحركة. وقيمتها في اكتشاف الأخطاء المستقلة عن النموذج، مثل فعل يحتاج ثماني ثوانٍ بدل خمس، أو دفع للكاميرا يقطع رأس الشخصية. أما اللوحات التي شغّلتها من قبل فتجاوز تمريرة الحركة وانتقل مباشرة إلى Turbo.
التوقيت: خطط بالدقائق لا بالثواني
استغرق كل إطار من GPT Image 2.5 Flare نحو 27 ثانية في اختبارات سبتمبر 2026. أما Seedance 2.5 فأبطأ مما توحي به مواصفاته. ففي اختبارنا المباشر استغرق مقطع Turbo من صورة إلى فيديو مدته 4 ثوانٍ بدقة 720p نحو تسع دقائق من الإرسال إلى الملف النهائي خلال أسبوع الإطلاق، وكان معظمها على ما يبدو وقت انتظار في الطابور لدى المزوّد. خطط لأن يستغرق التشغيل الكامل من 10 إلى 20 دقيقة، وافعل شيئًا آخر أثناء ذلك. يمكنك إغلاق التبويب؛ فـ Canvas يواصل العمل وتصل النتائج إلى العقد.
مقارنة مولدات لوحات القصة بالذكاء الاصطناعي
تتقاطع هذه الأدوات مع سير عمل Storyboard to Film بطرق مختلفة. وقد جرى التحقق من ادعاءات الميزات أدناه في الصفحات العامة للبائعين في سبتمبر 2026؛ وحيثما لا ينص البائع على شيء علنًا يذكر الجدول ذلك.
| الأداة | الإطارات | تحويل الإطارات إلى فيديو | اتساق الشخصية | ملاحظات |
|---|---|---|---|---|
| MakeInfluencer.ai Storyboard to Film | GPT Image 2.5 Flare أو Sunburst وNano Banana Pro وغيرها | نعم، ضمن التشغيل نفسه: Seedance 2.5 وSeedance 2.5 Turbo وWan 3.0 وKling 3.0 وGemini Omni | شخصيتك بالذكاء الاصطناعي أو صورة مرجعية، تُغذّى إلى كل إطار | لوحة تحكم وCanvas وREST API وMCP؛ وتكلفة الأرصدة معروضة قبل كل تشغيل |
| Higgsfield Popcorn | نموذج لوحة قصة خاص بها، حتى 8 إطارات وحتى 4 مراجع | تُستخدم الإطارات كإطارات بداية لنماذج فيديو منفصلة مثل Kling أو Veo | مراجع مع توليد تسلسل متسق | تطبيق؛ والأرصدة معروضة قبل التوليد |
| LTX Studio | نصوص تُقسَّم إلى مشاهد ولقطات؛ إطارات FLUX أو Nano Banana | نعم: نماذج LTX الخاصة بها، إضافةً إلى نماذج شركاء تذكرها مراجعات مستقلة ومنها Kling وSeedance وVeo | شخصيات وأغراض تُحفظ باسم «Elements» قابلة لإعادة الاستخدام | تطبيق مبني للمعاينة المسبقة (pre-vis) وعروض الأفكار |
| Boords | صور رسوم توضيحية أو متجهة أو واقعية من نص | لا مقاطع فيديو؛ عروض متحركة (animatics) بصوت لضبط التوقيت | تسمّي الممثلين والأماكن والأغراض مرة واحدة وتشير إليها بـ @ | مبنية للوكالات وفرق العلامات التجارية |
| StoryboardHero | إطارات بعنوان ووصف وفعل وتعليق صوتي لكل إطار | تصدير عرض متحرك بصيغة MP4، وليس فيديو مولَّدًا | ليست ميزة بارزة في صفحاتها العامة | موجّهة للتسويق والفيديو الاجتماعي |
وطريقة قراءة هذا الجدول: إن كنت تحتاج فقط إلى لوحة تعرضها على عميل، فـ Boords وStoryboardHero مبنيتان خصيصًا لذلك وتضمّان أدوات مراجعة لا تملكها الأخريات. وإن أردت أداة أفلام متكاملة بخط زمني، فـ LTX Studio هي الأكثر اكتمالًا. أما Higgsfield Popcorn فتنتج لوحات أطول (حتى ثمانية إطارات) باتساق قوي داخل التطبيق لكنها تترك التحريك لخطوة منفصلة. وميزة قالب Storyboard to Film لصنّاع المحتوى أضيق ومحددة: اللوحة تُبذَر من شخصية تملكها أصلًا، والإطارات والمقاطع تعمل في مخطط واحد، وكل عقدة قابلة للاستبدال بأي نموذج على المنصة.
ولنظرة أوسع على حزمة Higgsfield، راجع دليل بدائل Higgsfield. وللمفاضلات بين نماذج الفيديو عمومًا، راجع أفضل مولدات الفيديو بالذكاء الاصطناعي في 2026.
النسخة بنقرة واحدة: Storyboard to Film في AI Canvas
يجمع قالب Storyboard to Film كل ما سبق في تشغيل واحد. افتح AI Canvas، واختر القالب من قوالب الأفلام، وأسقط فكرتك الموجزة في العقدة الأولى وشخصيتك في الثانية، ثم اضغط «تشغيل».
وهذا ما يعمل بالضبط:
- عقدة موجز القصة واحدة، معبأة مسبقًا بقالب لملء الفراغات: القصة والمكان والأزياء والنبرة.
- عقدة شخصية واحدة، موصولة بكل عقدة إطار بوصفها مرجعًا للوجه.
- أربع عقد كاتب لقطات (نموذج لغوي)، لكل منها موجّه النظام الخاص بالمخرج وتعليمة الإيقاع الخاصة بها (التأسيس، والحركة، واللقطة القريبة، والحل)، بدرجة حرارة 0.8 وحتى 160 رمزًا (token).
- أربع عقد GPT Image 2.5 Flare للإطارات بنسبة 16:9 ودقة 1K وجودة متوسطة، بمخرج واحد لكل عقدة.
- أربع عقد Seedance 2.5 Turbo للمقاطع بدقة 720p ومدة خمس ثوانٍ وصوت مفعّل. وتتلقى كل عقدة إطارها بوصفه إطار البداية ووصف لقطتها بوصفه الموجّه.
وكل عقدة قابلة للتحرير. وأشيع التعديلات:
- اضبط عقدة مقطع واحدة على Seedance 2.5 القياسي و1080p للقطة البطل.
- ارفع المدة إلى 8 أو 10 ثوانٍ في لقطة الحركة.
- بدّل عقدة إطار إلى GPT Image 2.5 Sunburst حين تحتاج إلى تعديل دقيق لصورة ثابتة موجودة بدل إطار جديد.
- اضبط جودة الإطار على «عالية» حين تريد صورة ملصق بدرجة عالية.
- عدّل موجّه النظام الخاص بالمخرج في كتّاب اللقطات الأربعة لتغيير الأسلوب العام، مثل «وثائقي، كاميرا محمولة، إضاءة متاحة».
وافق على اللوحة قبل تشغيل المقاطع
شغّل القالب مرة واحدة، وراجع الإطارات الأربعة، وأعد توليد ما يحتاج إلى إعادة فقط. فكل مقطع يقرأ إطاره الحالي، لذا فإن إصلاح إطار وإعادة تشغيل مقطعه يكلّف مقطعًا واحدًا لا أربعة.
ما بعد الأربع لقطات
الأربع لقطات شكل انطلاق لا حدّ. وللتوسع:
- إيقاعات أكثر. انسخ كاتب اللقطات وسلسلة الإطار والمقطع، وامنح كاتب اللقطات الجديد تعليمة الإيقاع الخاصة به («اكتب اللقطة الخامسة، ردة فعل شخصية ثانية...»). ثم صِل عقدتي الفكرة الموجزة والشخصية به.
- لقطات أطول. يمكن لأي مقطع أن يصل إلى 30 ثانية على Seedance 2.5. وبعد ذلك استخدم Seedance 2.5 Video Extend عبر API لمواصلة مقطع بعد آخر 30 ثانية.
- مشاهد متعددة. شغّل القالب مرة لكل مشهد بفكرة موجزة خاصة بالمشهد والشخصية نفسها. وأبقِ سطري الأزياء والنبرة متطابقين عبر الأفكار الموجزة.
- قص عمودي. غيّر عقد الإطارات إلى 9:16. فمقاطع الصورة إلى فيديو تتبع شكل إطارها الأول، فيصبح التسلسل كله عموديًا لمقاطع Reels وTikTok.
بناء خط الإنتاج نفسه عبر API
كل ما في القالب متاح عبر REST API في MakeInfluencer.ai، وهذا مفيد حين تريد توليد لوحات كثيرة من جدول بيانات للأفكار الموجزة. وسير العمل كما يلي:
- ولّد كل إطار بالنموذج
gpt-image-2.5-flare، مع تمرير صورة الشخصية فيimageUrls. - استعلم دوريًا عن
/generations/image/{id}إلى أن تصبحterminalبقيمة true ويظهر العنوان. - أرسل كل مقطع إلى
seedance25turboمع عنوان الإطار فيstartFrameUrl. تختار API مسار الصورة إلى فيديو تلقائيًا حين يكون إطار البداية موجودًا. - استعلم دوريًا عن
/generations/video/{id}إلى أن تصبحterminalبقيمة true.
وفي دليل Seedance 2.5 API أمثلة كاملة للطلبات والاستجابات، وتسرد صفحة GPT Image 2.5 Flare API كل معامل للإطارات. وتُشارَك الأرصدة بين لوحة التحكم وCanvas وAPI، ويعيد preview-credits التكلفة الدقيقة لأي طلب دون أي خصم.
الأسئلة الشائعة
ما مولد لوحة القصة بالذكاء الاصطناعي؟
أداة تحوّل نصًا أو فكرة موجزة إلى سلسلة من الإطارات الثابتة، واحد لكل لقطة، لتخطط للفيديو وتوافق عليه قبل إنتاجه. وأدوات لوحات القصة إلى فيديو مثل قالب Storyboard to Film تضيف خطوة الإنتاج: فكل إطار معتمد يُحرَّك إلى مقطع.
هل أستطيع صنع فيلم قصير بالذكاء الاصطناعي بهذه الطريقة؟
نعم. ينتج تشغيل واحد أربعة مقاطع مدة كل منها خمس ثوانٍ، أي تسلسلًا مدته 20 ثانية بشخصية واحدة وقوس مكتمل. ارفع المدد، أو أضف سلاسل لقطات، أو شغّل القالب مرة لكل مشهد للأفلام الأطول. أما الإنتاج بطول فيلم روائي فليس شيئًا ينتجه أي نموذج فيديو حالي في تمريرة واحدة؛ لكن الأفلام القصيرة من دقيقة إلى ثلاث دقائق واقعية بعدة تشغيلات وأداة مونتاج.
أيهما أفضل لإطارات لوحة القصة: GPT Image 2.5 أم Nano Banana Pro؟
يتبع GPT Image 2.5 Flare تعليمات التأطير بدقة أكبر ويكلّف $0.039 للإطار المرجعي مقابل $0.14 لـ Nano Banana Pro. وقد يكون Nano Banana Pro أحيانًا أقوى في الحفاظ على وجه متطابق عبر عدة إطارات. جرّب كليهما على اللقطة الأولى واحتفظ بما يطابق شخصيتك. وتتعمق مقارنة GPT Image 2.5 مع Nano Banana Pro أكثر في ذلك.
هل تبقى الشخصية متسقة عبر المقاطع الأربعة؟
تذهب صورة الشخصية المرجعية إلى كل إطار، ويحرّك Seedance 2.5 الإطار الذي أعطيته بالضبط، لذا يكون التشابه أفضل بكثير من توليد الفيديو من النص وحده. لكنه ليس مثاليًا: فانحراف الوجه عند التفات الرأس والوجوه الصغيرة جدًا هما أكثر المشكلات. افحص الإطارات الأربعة جنبًا إلى جنب وأعد توليد أي إطار يكون وجهه معطوبًا قبل تشغيل مقطعه.
كم يستغرق التشغيل؟
تستغرق الإطارات نحو نصف دقيقة للإطار الواحد. أما المقاطع فتستغرق وقتًا أطول: ففي اختبارنا في أسبوع الإطلاق استغرق مقطع Seedance 2.5 Turbo واحد نحو تسع دقائق. خطط لـ 10 إلى 20 دقيقة للتشغيل الواحد.
هل أستطيع تحويل رسومات لوحة القصة التي أرسمها إلى فيديو؟
نعم، بخطوة إضافية واحدة. أضف عقدة إدخال صورة برسمك، وصلها بعقدة إطار، واطلب من GPT Image 2.5 Sunburst تصييرها بأسلوب واقعي مع مرجع الشخصية مع الحفاظ على التكوين. ثم حرّك الإطار المُصيَّر. أما تحريك رسم بالقلم والخطوط مباشرة بنموذج الفيديو فيميل إلى إنتاج رسوم متحركة، وهو نادرًا ما تريده.
كم تكلّف؟
نحو $4.16 بسعر قائمة المزوّد لتشغيل افتراضي من أربعة إطارات وأربعة مقاطع، ويظهر على زر التشغيل قبل البدء. وتمثل الإطارات نحو 4 بالمئة من ذلك. وترقية المقاطع الأربعة كلها إلى Seedance 2.5 القياسي بدقة 720p ترفع الإجمالي إلى نحو $7.36.
هل توجد طريقة مجانية لتجربتها؟
ليس للقالب كاملًا: فالإطارات والمقاطع تعمل بالأرصدة، والحسابات الجديدة لا تأتي بأرصدة مجانية، لذا راجع صفحة التسعير لمعرفة الخطط الحالية. أما ما يمكنك فعله مجانًا فهو رسم إطارات منفردة بالمعاينة في صفحة مولد لوحة القصة بالذكاء الاصطناعي، التي تشغّل نموذج الصور المفتوح الخاص بنا دون حساب. ولن تضاهي إطارات GPT Image 2.5، لكنها تكفي لاختبار التأطير والعدسة قبل إنفاق الأرصدة.
ابدأ لوحتك الأولى
أنشئ حسابًا واختر خطة
سجّل في MakeInfluencer.ai واختر خطة أو حزمة أرصدة من صفحة التسعير.
افتح AI Canvas واختر Storyboard to Film
ألصق فكرة موجزة من فقرة واحدة تتضمن القصة والمكان والأزياء والنبرة، واختر شخصيتك، ثم اضغط «تشغيل».
وافق على الإطارات ثم أنجز المقاطع
أعد توليد أي إطار يحتاج إلى ذلك، وارفع لقطة البطل إلى Seedance 2.5 القياسي، ثم قصّ المقاطع الأربعة معًا مع مسار موسيقي واحد.
افتح AI Canvas لتشغيل القالب، أو جرّب لقطات منفردة في مولّد الفيديو بالذكاء الاصطناعي، أو اقرأ دليل Seedance 2.5 API لبناء خط الإنتاج نفسه برمجيًا. الأسئلة: [email protected].