Publié le 29 septembre 2026. Les prix des modèles sont les tarifs publics des fournisseurs à cette date, tirés du même tableau de prix qui alimente le calculateur de crédits de MakeInfluencer.ai. La plateforme affiche le coût exact en crédits avant chaque exécution.
La plupart des vidéos IA échouent au même endroit. Tu écris un long prompt, tu attends le rendu, et tu obtiens un clip où le visage a changé, le cadrage est raté et la lumière a varié en cours de route. Tu relances, et chaque relance consomme des crédits vidéo, les plus chers de tous.
Les cinéastes ont résolu ce problème bien avant les modèles génératifs. Ils dessinent un storyboard : une image fixe par plan, validée avant le début du tournage. La même discipline fonctionne pour la vidéo IA, et elle fonctionne mieux aujourd'hui, car deux modèles excellent chacun sur une moitié du travail. OpenAI GPT Image 2.5 dessine des images précises et cohérentes d'un même personnage pour quelques centimes pièce. ByteDance Seedance 2.5 anime une image validée en clip avec son synchronisé natif, en respectant ce que l'image a établi.
Ce guide est la version longue. Il explique comment écrire un découpage qu'un modèle peut suivre, comment garder un personnage stable d'une image à l'autre, quel vocabulaire cinématographique change vraiment le résultat, des modèles de prompts pour chaque type de plan, un exemple complet du brief aux quatre clips finis avec chaque prompt, le détail des coûts, un workflow de brouillon économique et une comparaison honnête avec d'autres générateurs de storyboard IA. La dernière partie présente la version en un clic : le modèle Storyboard to Film dans AI Canvas.
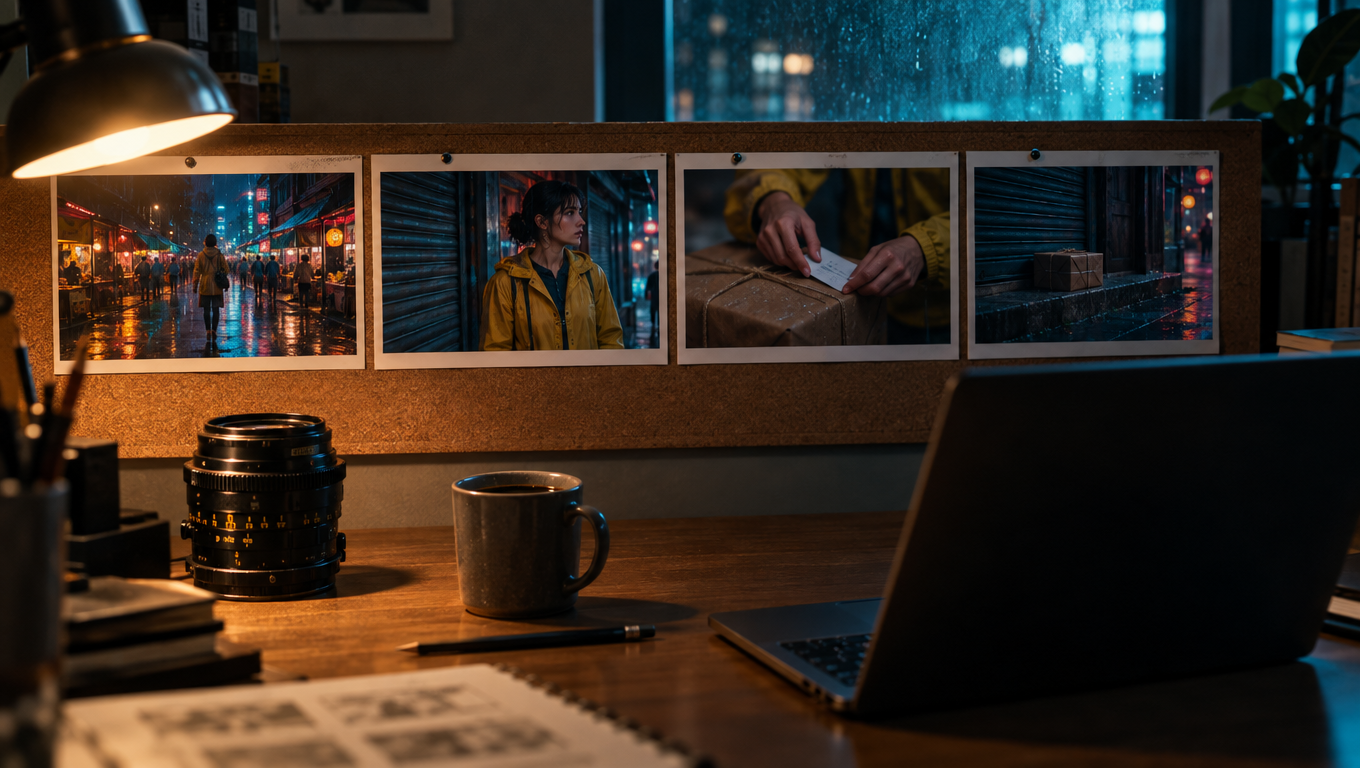
Ce que fait vraiment un générateur de storyboard IA
Un générateur de storyboard IA transforme un script ou un brief court en une séquence d'images fixes, une par plan, pour que tu puisses voir et valider une vidéo avant de la produire. Les anciens outils s'arrêtaient là : ils dessinaient des croquis ou des illustrations de banque d'images pour une réunion client. La nouvelle génération d'outils storyboard-vers-vidéo ajoute l'étape de production. Chaque image validée devient l'image de départ d'un clip vidéo : le storyboard n'est plus un plan du film, il en est la première moitié.
Ce changement compte parce que les modèles d'image et les modèles vidéo n'échouent pas de la même façon. Les modèles d'image sont bons pour la composition, les costumes, les visages et la lumière, et ils coûtent peu à relancer. Les modèles vidéo sont bons pour le mouvement et le son, mais quand tu leur demandes aussi d'inventer la composition, ils se mettent à deviner, et ces petites approximations s'accumulent sur cinq ou dix secondes. Un storyboard sépare le problème : le modèle d'image décide de l'apparence du plan, le modèle vidéo décide seulement de son mouvement.
Pourquoi commencer par le storyboard
Un storyboard IA est un brief de production, pas un moodboard. Chaque image répond à deux questions : qu'est-ce qui doit rester fixe (le personnage, les costumes, le décor, la lumière) et qu'est-ce qui va bouger (une action, un mouvement de caméra). Une fois l'image validée, le modèle vidéo n'a presque rien à inventer.
Trois effets concrets en découlent :
- Tu fixes l'apparence avant de dépenser des crédits vidéo. Une image GPT Image 2.5 Flare avec une référence de personnage, en 1K et qualité moyenne, coûte 0,039 $ au tarif public. Un clip Seedance 2.5 Turbo de cinq secondes en 720p coûte 1,00 $. L'image revient environ 25 fois moins cher : c'est donc là que tu itères.
- La même référence alimente chaque plan. L'image de référence de ton personnage entre dans chaque image : le visage reste donc cohérent d'un plan à l'autre au lieu de dériver.
- Tu régénères une image ou un clip, pas toute la séquence. Si le plan trois est raté, tu ne relances que le plan trois.
Les deux modèles, et pourquoi ils vont bien ensemble
GPT Image 2.5 Flare (images)
Le modèle d'image d'OpenAI de septembre 2026. Plus net que GPT Image 2 pour environ la moitié de la latence, solide sur le cadrage et le respect des consignes, et il accepte jusqu'à 16 images de référence, ce qui permet de garder le personnage cohérent. Chaque image a pris environ 27 secondes dans nos tests.
Seedance 2.5 (clips)
Le modèle vidéo phare de ByteDance, lancé le 31 juillet 2026. Il anime une image de départ en clip de 4 à 30 secondes avec audio synchronisé, conserve le sujet, les costumes et l'éclairage de l'image, et propose une image de fin optionnelle. Turbo pour les brouillons, standard pour les versions finales.
GPT Image 2.5 existe en deux variantes sur MakeInfluencer.ai. Flare est le modèle de génération utilisé par le template. Sunburst est conçu pour les retouches de précision qui préservent les visages, les produits et les mises en page : c'est le bon outil quand tu veux changer un seul élément d'une image validée (la couleur de la veste, la position du personnage vers la gauche) sans redessiner le reste.
Seedance 2.5 existe aussi en deux niveaux. Seedance 2.5 Turbo tourne en 720p ou 1080p pour 0,20 $ ou 0,22 $ la seconde. Seedance 2.5 Standard tourne du 480p à la 4K et coûte 0,36 $ la seconde en 720p. Les deux acceptent le même prompt et la même image de départ : faire passer un plan du brouillon à la version finale revient donc à changer de modèle, pas à tout réécrire.
Tu peux remplacer l'une ou l'autre moitié. Nano Banana Pro de Google est un bon modèle d'image quand un visage identique sur de nombreuses images compte plus que la précision de la composition, même s'il coûte 0,14 $ l'image. Wan 3.0 d'Alibaba est le moyen le moins cher d'animer en 720p, à 0,10 $ la seconde. Le template utilise par défaut GPT Image 2.5 Flare et Seedance 2.5 Turbo, car ce duo offre actuellement la meilleure précision d'image par dollar et le meilleur mouvement par dollar.
Un mot sur Sora 2
OpenAI a retiré l'API Sora 2 Videos le 24 septembre 2026. Les anciens tutoriels de storyboard qui animent des images avec Sora 2 ne fonctionnent plus via aucune API. Seedance 2.5, Wan 3.0, Kling 3.0 et Veo 3.1 Fast sont aujourd'hui les options concrètes pour animer des images de storyboard.
L'art du découpage en plans : ce que la plupart des storyboards IA oublient
Avant de lancer le moindre modèle, il te faut un découpage : la liste ordonnée des plans, ce que chacun montre et pourquoi il existe. La plupart des courts métrages IA décevants ne sont pas des échecs du modèle. Ce sont quatre belles images sans raison d'apparaître dans cet ordre.
La structure en quatre temps
Le template utilise une structure en quatre temps empruntée à la publicité courte et aux exercices d'école de cinéma. Elle est assez petite pour être produite en une séance et assez complète pour ressembler à une histoire.
| Plan | Rôle | Cadrage | Ce que le spectateur comprend |
|---|---|---|---|
| 1. Établissement | Montre le monde | Plan large, grande profondeur de champ, personnage petit à moyen dans le cadre | Où l'on est, à quelle heure, quelle est l'ambiance |
| 2. Action | Montre l'événement principal | Plan moyen, poitrine vers le haut, un geste physique clair | Ce que le personnage veut et fait |
| 3. Gros plan | Montre l'émotion | Visage et mains, faible profondeur de champ | Ce que le personnage ressent face à ce qui s'est passé |
| 4. Résolution | Boucle l'histoire | Plus large ou fixe, tenu un moment | Où finit le personnage ; l'ambiance a changé |
La progression du plan large au plan moyen puis au gros plan, et le retour en arrière, n'est pas décorative. C'est ainsi que les monteurs guident le regard du public depuis un siècle. Un plan large dit au spectateur où il se trouve. Se rapprocher lui dit ce qui compte. Reculer à la fin lui laisse de l'espace pour ressentir la conclusion. Si tu casses ce schéma, fais-le exprès : une histoire qui s'ouvre sur un gros plan de mains et ne révèle la pièce qu'au plan deux peut fonctionner, mais seulement si le brief le demande.
Une action par plan
Un clip de cinq secondes ne contient qu'une action. « Elle se retourne, marche vers la porte, l'ouvre et regarde derrière elle » fait quatre actions, et le résultat sera un flou précipité ou un clip qui s'arrête en cours de route. « Elle pousse la porte de l'épaule » est une action qu'un modèle vidéo peut animer proprement en cinq secondes. Si ton histoire demande davantage, il lui faut plus de plans, ou une durée plus longue pour ce plan.
Un test utile : décris le plan à un ami en une seule phrase contenant un seul verbe de mouvement. Si tu as besoin de dire « et puis », découpe-le.
Les règles de continuité à écrire noir sur blanc
La continuité, c'est ce qu'un storyboarder humain fait sans y penser et qu'un modèle ne fait pas du tout. Note ces points une fois dans le brief, et le rédacteur de plans les reportera dans chaque plan :
- Costumes. Nomme chaque vêtement visible et sa couleur. « Imperméable jaune, pantalon cargo noir, sac de coursier gris en bandoulière. »
- Heure et météo. « Nuit, pluie fine, sol mouillé. » S'il pleut au plan un et que tout est sec au plan trois, la séquence s'effondre.
- Source de lumière. « Les enseignes au néon sont la lumière principale. » Cela garde la couleur de la lumière cohérente.
- Sens de déplacement à l'écran. Si le personnage se déplace de gauche à droite au plan deux, il ne doit pas arriver par la droite au plan quatre, sauf s'il fait demi-tour. Précise « elle se déplace de gauche à droite dans tout le film » si le sens compte.
- Accessoires. Le colis du plan deux doit être le même colis au plan quatre.
Ce qu'il faut laisser hors du brief
Écarte le dialogue : une image ne peut pas le porter, et il pousse le modèle vidéo à animer les lèvres sans audio correspondant. Écarte le texte à l'écran et les noms de marque : le texte dans les images générées n'est pas fiable, et les logos posent des problèmes de droits. Écarte le jargon cinématographique dans le brief lui-même : le rédacteur de plans ajoute l'objectif et la lumière plan par plan, et un brief qui dit « anamorphique 35 mm » pousserait tous les plans vers le même cadrage.
Garder le même personnage d'une image à l'autre
La cohérence est la raison même d'utiliser un workflow de storyboard : elle mérite donc sa propre section. Elle repose sur trois couches, et il te faut les trois.
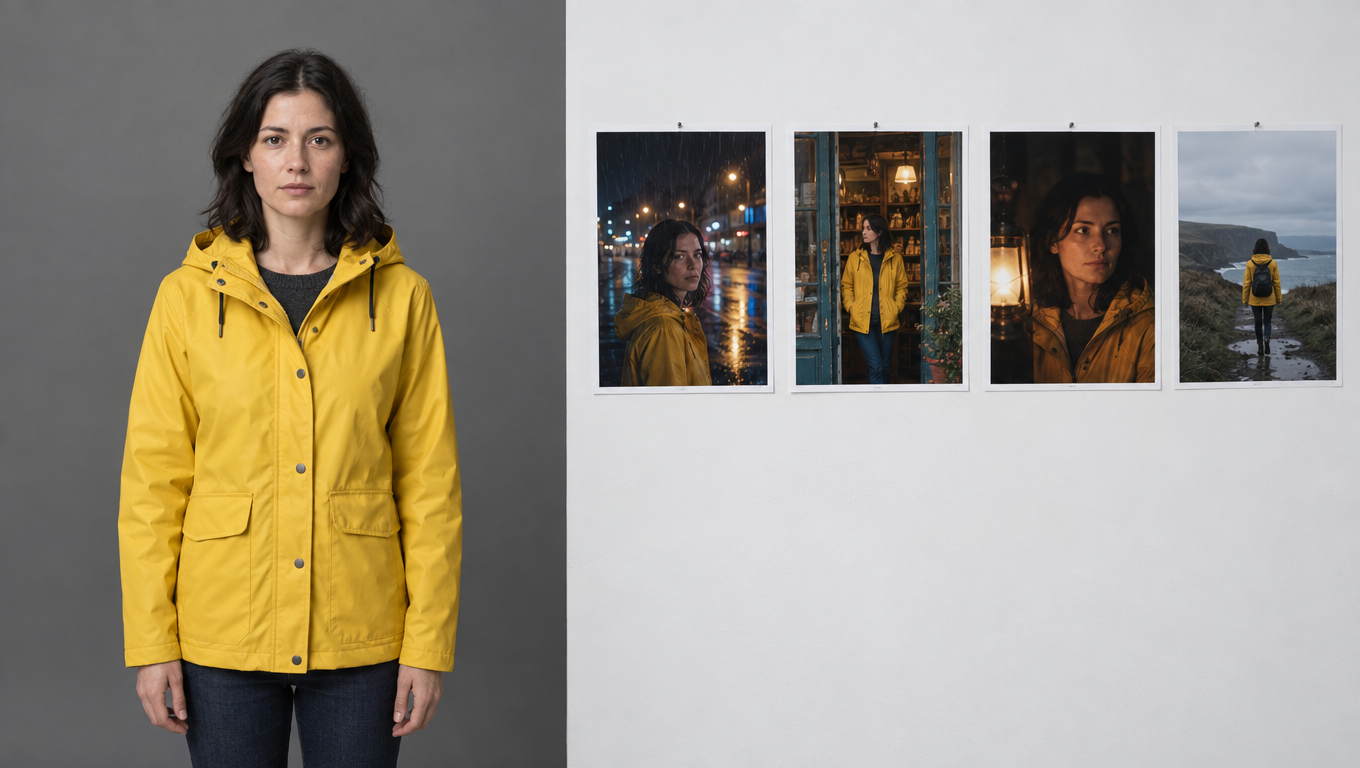
Couche 1 : une image de référence propre
Chaque image reçoit la même image de référence du personnage. Cette référence doit être un portrait bien éclairé, de face ou de trois quarts, visage dégagé, expression neutre, idéalement avec le costume voulu pour le film. Une photo de référence en chemise blanche contredit un brief qui demande une veste jaune : le modèle doit décider laquelle croire, et il ne tranchera pas de la même façon à chaque fois.
Si tu as déjà un influenceur IA sur MakeInfluencer.ai, le nœud de personnage récupère directement son image de référence. Sinon, importe un portrait propre. Le guide de création d'un personnage IA cohérent explique comment créer une référence qui tient dans de nombreuses scènes, et le guide de cohérence des personnages détaille les compromis entre images de référence et modèles entraînés.
Couche 2 : le verrouillage de l'identité dans le prompt
La référence seule ne suffit pas : le prompt doit dire au modèle d'image ce qu'il doit en faire. Le prompt d'image du template dit, dans sa deuxième phrase : « The person in the reference image is the lead character: keep face, hair, skin tone and build identical to the reference. » Cette consigne place la référence au-dessus de tout ce que dit la description du plan, ce qui est exactement ce que tu veux quand le rédacteur de plans décrit le personnage de façon vague.
Couche 3 : l'image sert de référence pour le clip
Quand Seedance 2.5 anime une image, cette image est l'image de départ. Le modèle part exactement de ces pixels : l'identité de l'image est donc aussi celle de la première image du clip. La dérive dans le clip vient du mouvement : un tour de tête qui révèle un profil que l'image n'a jamais montré, ou un gros plan qui invente un détail. Le prompt du clip y répond avec « garde le personnage, les costumes, le décor et l'éclairage exactement comme dans l'image » et en demandant un seul mouvement de caméra, pas trois.
Vérifie les visages avant d'animer
Mets les quatre images côte à côte et ne regarde que le visage. Si le visage d'une image est raté, régénère cette image avant de lancer son clip. Corriger un visage sur une image à 0,039 $ coûte toujours moins cher que le découvrir dans un clip à 1,00 $.
Ce qui pose encore problème
Ce n'est pas parfait. Voici les défauts que tu verras le plus souvent :
- Plans de profil. Une référence de face ne dit pas au modèle à quoi ressemble le profil du personnage. Si un plan demande un profil, ajoute une deuxième image de référence prise de côté.
- Visages très petits. Sur un plan large d'établissement, le visage peut faire 40 pixels de haut. Le modèle a moins de repères et dérive davantage. C'est généralement acceptable sur un plan large : le spectateur lit la silhouette et le costume.
- Mains et accessoires. Les mains qui tiennent des objets restent un point faible des modèles d'image et de vidéo. Garde les actions des mains simples : tenir, poser, pousser. Évite tout ce qui exige une interaction précise des doigts.
Le langage cinématographique qui change le résultat
Les deux modèles comprennent le vocabulaire cinématographique courant, mais tous les termes n'ont pas d'effet. Voici ceux qui changent de façon fiable ce que tu obtiens.
Termes de cadrage (pour le modèle d'image)
| Terme | Ce qu'en fait GPT Image 2.5 | À utiliser pour |
|---|---|---|
| Plan d'ensemble / plan large d'établissement | Personnage petit, environnement dominant | Plan 1 |
| Plan en pied | De la tête aux pieds dans le cadre | Montrer le costume et la posture |
| Plan moyen / poitrine vers le haut | Torse et mains, visage lisible | Plan 2, la plupart des actions |
| Plan rapproché poitrine | Poitrine vers le haut | Réactions avec un peu de contexte |
| Gros plan | Le visage remplit la plupart du cadre | Plan 3 |
| Plan par-dessus l'épaule | Épaule au premier plan, sujet au fond | Scènes à deux personnages |
| Contre-plongée | Caméra sous la ligne des yeux, le sujet paraît puissant | Moments de résolution |
| Plongée | Caméra au-dessus, le sujet paraît petit | Isolement, défaite |
La focale est un raccourci utile pour la perspective. Le « 24 mm » donne une vue large, légèrement étirée, avec beaucoup d'environnement. Le « 35 mm » est la valeur par défaut d'un récit naturel. Le « 50 mm » est proche de la vision humaine. Le « 85 mm » compresse l'arrière-plan et isole un visage. Le modèle ne simule pas exactement l'optique, mais ces chiffres déplacent le cadrage dans le sens attendu.
Termes de mouvement (pour le modèle vidéo)
| Terme | Ce qu'en fait Seedance 2.5 | Idéal pour |
|---|---|---|
| Travelling avant lent | La caméra avance vers le sujet | Créer de la tension, insister |
| Travelling arrière | La caméra s'éloigne | Conclusions, révélations |
| Plan de suivi | La caméra accompagne le sujet | Marche, course |
| Panoramique gauche ou droite | La caméra pivote sur son axe | Révéler un espace |
| Panoramique vertical haut ou bas | La caméra pivote à la verticale | Révéler la hauteur |
| Caméra à l'épaule | Léger tremblement organique | Urgence, effet documentaire |
| Plan fixe / statique | Aucun mouvement de caméra | Laisser l'action porter le plan |
| Orbite | La caméra tourne autour du sujet | Moments héroïques, avec parcimonie |
La règle la plus utile : un seul mouvement de caméra par plan. « Travelling avant lent tout en panoramiquant vers la gauche et en s'inclinant vers le haut » demande au modèle de gérer trois mouvements à la fois, et il en réussira rarement plus d'un. Si un plan exige un mouvement complexe, c'est probablement qu'il faut deux plans.
La deuxième règle : accorde le mouvement de caméra au rôle du plan. Un plan d'établissement appelle un panoramique lent ou un travelling avant lent, qui laisse au spectateur le temps de lire l'espace. Un plan d'action appelle un suivi ou une caméra à l'épaule. Un gros plan appelle soit rien, soit un travelling avant très lent. Un plan de résolution appelle un travelling arrière ou un cadre fixe qui laisse respirer le moment.
Modèles de prompts par type de plan
Le template assemble chaque prompt à partir de deux parties : la description du plan (rédigée à neuf pour chaque plan par le LLM réalisateur) et une spécification fixe (identique pour les quatre plans). Sur le canvas, la description du plan vient d'abord, puis une ligne vide, puis la spécification. Voici ce que chaque partie doit contenir, avec des modèles réutilisables.
La spécification d'image (fixe pour toutes les images)
Voici le texte exact que le template ajoute à chaque image :
Photoreal cinematic storyboard frame in 16:9. The person in the reference image is the lead character: keep face, hair, skin tone and build identical to the reference. Anamorphic feel on a 35mm lens, motivated natural light, fine film grain, muted graded palette. Compose the frame so it can be animated into a five-second shot. Avoid: on-screen text, captions, logos, watermarks, split screens, extra people, distorted hands.
Deux phrases font plus de travail qu'il n'y paraît. « Compose the frame so it can be animated » éloigne le modèle des compositions figées et surchargées, au profit d'images qui laissent de la place au mouvement. « Split screens » dans la liste des éléments à éviter empêche GPT Image 2.5 de renvoyer parfois un storyboard multi-cases dans une seule image, ce qui arrive réellement quand le mot « storyboard » figure dans le prompt.
La spécification de clip (fixe pour tous les clips)
Animate this storyboard frame as the shot described above. Keep the character, wardrobe, set and lighting exactly as in the frame. One clear camera move, natural believable motion, ambient sound design that matches the scene, no music, no on-screen text.
« No music » est voulu. Quatre clips avec quatre nappes musicales générées différentes ne se montent pas ensemble. Le son d'ambiance (pluie, circulation, pas, ambiance de pièce) se raccorde proprement, et tu peux poser une piste de musique sur la séquence terminée dans n'importe quel logiciel de montage.
Modèles de description de plan
Chaque description de plan doit suivre la même forme en trois phrases : ce qu'on voit et où se trouve le personnage ; ce que fait le personnage ; cadrage, objectif, lumière et ambiance. Ces modèles fonctionnent bien comme points de départ :
Plan large d'établissement. « Plan large de [lieu] à [heure], [météo]. [Personnage] est [petit ou moyen] dans le cadre, [une action tranquille qui définit l'ambiance]. Objectif 24mm, champ profond, [source de lumière] comme lumière principale, atmosphère [ambiance]. »
Plan d'action moyen. « Plan moyen, poitrine vers le haut, de [personnage] [action physique unique] dans [partie du lieu]. [Un détail qui montre l'intention ou l'enjeu]. Objectif 35mm, [source de lumière] de [direction], ambiance [mot d'énergie]. »
Gros plan émotionnel. « Gros plan du visage et des mains de [personnage] comme [la réaction ou la réalisation]. [Un changement d'expression]. Objectif 85mm, faible profondeur de champ, [lumière motivée], [ambiance]. »
Résolution. « [Cadrage plus large ou statique] de [personnage] [position finale ou action] dans [lieu]. [Comment l'environnement ou la lumière a changé depuis le plan un]. [Objectif], [lumière], l'ambiance a changé en [nouvelle ambiance]. »
Le prompt système du réalisateur utilisé par le template demande au LLM de ne produire que ce type de description en deux ou trois phrases, sans titres, listes ni commentaires, et de ne jamais réclamer de texte, de sous-titres ou de logos. Tu peux le modifier sur n'importe quel nœud de rédacteur de plans.
Un exemple complet : du brief aux quatre images, puis aux quatre clips
Voici une exécution complète, avec chaque prompt. Elle utilise les paramètres par défaut du template : GPT Image 2.5 Flare en 16:9, 1K, qualité moyenne pour les images, et Seedance 2.5 Turbo en 720p, cinq secondes, audio activé pour les clips.
Le brief
C'est le seul texte que tu écris :
Story: Mara, a 30-year-old courier, races the last delivery of the night through a rain-soaked market street and finds the shop already closed, then leaves the parcel on the step with a handwritten note tucked under the string. Setting: night market street, neon signage, light rain, wet cobblestones. Wardrobe: yellow rain jacket, black cargo trousers, grey courier bag across the chest. Tone: melancholic. Do not change the character's look between shots.
Pourquoi ça marche : un personnage, un lieu, un arc avec une fin, des costumes nommés une fois, une ambiance nommée une fois. Les briefs avec trois lieux ou deux personnages principaux produisent des storyboards qui dérivent, car chaque image est générée indépendamment et seuls le texte et la référence les relient.
Les quatre descriptions de plan
Les quatre nœuds de rédacteur de plans reçoivent chacun le brief plus leur consigne de temps. Un résultat typique ressemble à ceci (le LLM tourne à une température de 0,8 : la formulation du tien sera donc différente) :
Plan 1, établissement. « Wide shot of a narrow night market street glistening with rain, shuttered stalls and pink and teal neon signs reflecting in the wet cobblestones. Mara, in her yellow rain jacket with the grey courier bag across her chest, is small in the middle distance, jogging toward camera between the stalls. 24mm lens, deep focus, neon as the main light, cold melancholic atmosphere. »
Plan 2, action. « Medium shot, waist-up, of Mara stopping short in front of a small shop with its metal shutter pulled down, one hand still gripping the brown paper parcel. Rain beads on her yellow hood and her breath shows in the cold air. 35mm lens, teal neon from the left, tense and deflated mood. »
Plan 3, gros plan. « Close-up of Mara's face and hands as she tucks a folded handwritten note under the string of the parcel, eyes lowered. A small, tired half-smile. 85mm lens, shallow depth of field, warm spill from a nearby lantern against the cold neon, quiet and tender. »
Plan 4, résolution. « Static wide shot from across the street: the parcel sits alone on the shop's step under a small awning while Mara walks away to the right, her yellow jacket the only warm color in the frame. The rain has eased to a drizzle. 35mm lens, neon and lantern light, the mood has shifted from urgency to quiet acceptance. »
Remarque ce que le LLM a repris du brief sans qu'on le lui répète : la veste jaune, le sac gris, le néon, la pluie. C'est pourquoi le brief les nomme une seule fois, clairement.
Les quatre images
Chaque nœud d'image reçoit sa description de plan, la spécification d'image ajoutée après une ligne vide, et l'image de référence du personnage. Voici le prompt complet de l'image 2, exactement tel qu'il est envoyé :
Medium shot, waist-up, of Mara stopping short in front of a small shop with its metal shutter pulled down, one hand still gripping the brown paper parcel. Rain beads on her yellow hood and her breath shows in the cold air. 35mm lens, teal neon from the left, tense and deflated mood.

Photoreal cinematic storyboard frame in 16:9. The person in the reference image is the lead character: keep face, hair, skin tone and build identical to the reference. Anamorphic feel on a 35mm lens, motivated natural light, fine film grain, muted graded palette. Compose the frame so it can be animated into a five-second shot. Avoid: on-screen text, captions, logos, watermarks, split screens, extra people, distorted hands.
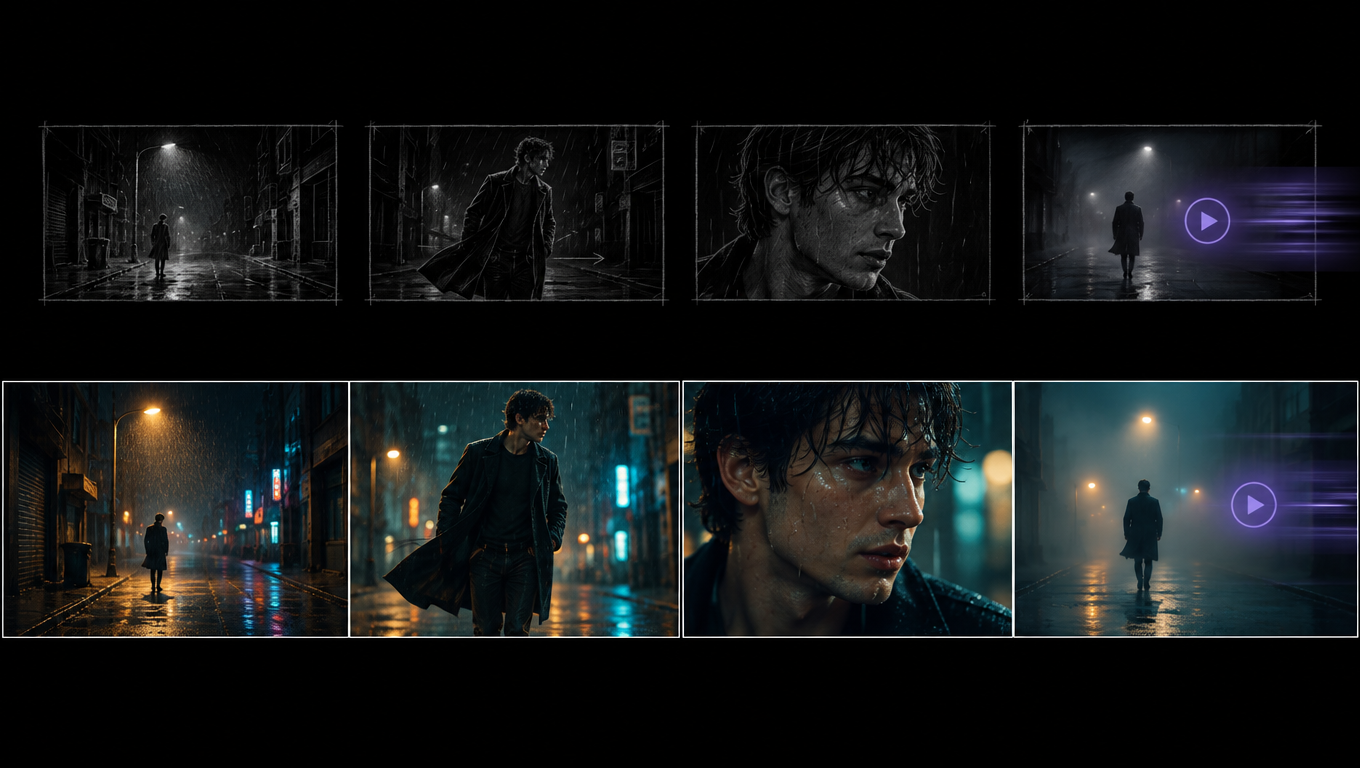
Passe les quatre images en revue avec une courte checklist avant de lancer le moindre clip :
- Est-ce bien le même visage sur les quatre images ?
- Les costumes sont-ils identiques, couleurs comprises ?
- La source de lumière est-elle cohérente (du néon ici, pas de la lumière du jour) ?
- Chaque image montre-t-elle exactement une action, avec de la place pour l'animer ?
- Un texte, un logo ou une personne en trop s'est-il glissé dans l'image ?
Dans une exécution typique, une image sur quatre demande un deuxième essai. Le cas le plus fréquent est le plan large d'établissement, où le personnage est petit et où le modèle ajoute parfois des silhouettes en trop dans une rue de marché. Relance ce seul nœud d'image ; les trois autres restent tels quels.
Les quatre clips
Chaque nœud de clip reçoit l'image comme image de départ, et la description du plan plus la spécification de clip comme prompt. Voici le prompt complet du clip 2 :
Medium shot, waist-up, of Mara stopping short in front of a small shop with its metal shutter pulled down, one hand still gripping the brown paper parcel. Rain beads on her yellow hood and her breath shows in the cold air. 35mm lens, teal neon from the left, tense and deflated mood.

Animate this storyboard frame as the shot described above. Keep the character, wardrobe, set and lighting exactly as in the frame. One clear camera move, natural believable motion, ambient sound design that matches the scene, no music, no on-screen text.
Si tu veux diriger le mouvement plus précisément que « un mouvement de caméra clair », ajoute une ligne au prompt du nœud de clip. Pour cette séquence :
| Clip | Ligne de mouvement ajoutée | Pourquoi |
|---|---|---|
| 1 | « Slow push-in as she jogs toward camera, footsteps splashing. » | Attire le spectateur dans la rue |
| 2 | « Handheld, slight shake, she exhales and her shoulders drop. » | L'urgence retombe en déception |
| 3 | « Locked-off, only her hands and eyes move. » | Laisse le petit geste porter le plan |
| 4 | « Slow pull-out while she walks out of frame to the right. » | Laisse le colis seul à la fin |
Le clip ci-dessus est un vrai rendu image-vidéo de Seedance 2.5 Turbo à partir de l'une des images du template. Quatre clips mis bout à bout font un film de 20 secondes. Monte-les dans n'importe quel logiciel, place une seule piste de musique en dessous, et tu obtiens un court métrage avec un personnage cohérent, un lieu et un arc complet.
Réparer un clip raté
Si un clip se comporte mal, fais un diagnostic avant de le relancer :
- Le visage dérive en milieu de clip. C'est généralement dû à un tour de tête. Ajoute « she keeps her face toward camera » ou choisis un mouvement de caméra qui ne révèle pas de nouvel angle.
- Trop de choses se passent. La description du plan contient deux actions. Réduis-la à une seule.
- Il ne se passe rien. L'image est trop chargée. Régénère-la avec une composition plus ouverte, ou ajoute une ligne d'action explicite au clip.
- Mauvais son. Nomme le son voulu : « rain on the awning, distant traffic, no voices. »
- Le clip est trop court pour l'action. Porte la durée de ce nœud à 8 ou 10 secondes. Seedance 2.5 accepte de 4 à 30 secondes.
Ce que ça coûte, ligne par ligne
Tous les chiffres ci-dessous sont des tarifs publics des fournisseurs issus du manifeste de tarification de MakeInfluencer.ai, vérifiés le 29 septembre 2026. La colonne des crédits utilise la conversion actuelle de la plateforme ; le bouton Run de Canvas affiche le total exact avant le lancement.
| Étape | Modèle et paramètres | Nombre | Tarif public unitaire | Crédits approx. unitaires |
|---|---|---|---|---|
| Rédaction des plans | LLM réalisateur | 4 | une fraction de centime | 1 000 |
| Images | GPT Image 2.5 Flare, 1K qualité moyenne, avec référence de personnage | 4 | 0,039 $ | 1 955 |
| Clips | Seedance 2.5 Turbo, 720p, 5s, audio activé | 4 | 1,00 $ | 50 126 |
| Total par exécution | environ 4,16 $ | environ 212 000 |
Les images avec une référence de personnage utilisent le tarif de retouche de GPT Image 2.5 (0,039 $ en 1K qualité moyenne) plutôt que son tarif texte-vers-image habituel (0,024 $), car l'image de référence est une entrée. Chaque référence supplémentaire au-delà de la première ajoute 0,015 $.
Les clips représentent 96 % de la facture. C'est tout l'intérêt de valider le storyboard d'abord.
Monter ou descendre en gamme
| Changement | Nouveau coût par clip (5 s) | Total pour quatre clips | Quand c'est utile |
|---|---|---|---|
| Par défaut : Seedance 2.5 Turbo 720p | 1,00 $ | 4,00 $ | Brouillons, montages pour les réseaux sociaux |
| Seedance 2.5 Turbo 1080p | 1,10 $ | 4,40 $ | Version finale pour la plupart des plateformes |
| Seedance 2.5 Standard 720p | 1,80 $ | 7,20 $ | Plans héros avec mouvement complexe |
| Seedance 2.5 Standard 1080p | 4,50 $ | 18,00 $ | Livrables clients |
| Wan 3.0 720p | 0,50 $ | 2,00 $ | Exécutions à petit budget, mouvement simple |
| Kling 3.0 Pro avec son | 0,84 $ | 3,36 $ | Si tu préfères le style de mouvement de Kling |
| Gemini Omni 1.1 Flash 360p | 0,15 $ | 0,60 $ | Tests de mouvement uniquement |
Une configuration mixte judicieuse : Turbo 720p sur les plans 1, 3 et 4, Seedance 2.5 standard en 720p sur le plan d'action. Cela fait 4,80 $ pour les clips, et la dépense supplémentaire va là où le mouvement est le plus difficile.
Côté image, passer la qualité à « haute » en 1K coûte 0,105 $ par image avec une référence, ce qui reste négligeable à côté des clips. Utilise-le quand tu envisages de tirer une affiche d'une image.
Le workflow de brouillon : teste le mouvement à petit prix avant de t'engager
Seedance 2.5 Turbo est déjà le niveau économique, mais pour un storyboard que tu comptes itérer beaucoup, il existe une première passe encore moins chère. Gemini Omni 1.1 Flash de Google rend des clips de 3 à 10 secondes en 360p pour 0,03 $ la seconde : un test de mouvement de cinq secondes coûte donc 0,15 $, soit environ 7 500 crédits. Il accepte les images de départ et l'audio est toujours activé.
Le workflow, que certaines plateformes vendent comme un « mode brouillon », se résume à trois passes :
Passe images
Exécute uniquement le brief, les rédacteurs de plans et les images. Valide les quatre images. Coût : environ 0,16 $ au tarif public.
Passe mouvement en 360p
Règle chaque nœud de clip sur Gemini Omni 1.1 Flash en 360p, cinq secondes. Repère les mouvements de caméra qui révèlent de mauvais angles, les actions qui ne collent pas et le rythme. Ajuste les lignes de mouvement. Coût : 0,60 $ pour quatre clips.
Passe finale
Remets les nœuds de clip sur Seedance 2.5 Turbo en 720p ou 1080p, ou sur Seedance 2.5 standard pour le plan héros, puis lance l'exécution. Coût : 4,00 $ à 7,20 $ selon le mélange.
La réserve est honnête : un brouillon en 360p sur un autre modèle t'informe sur la composition, le rythme et le mouvement de caméra, pas sur la façon exacte dont Seedance 2.5 rendra le mouvement. Son intérêt est de repérer les erreurs indépendantes du modèle, comme une action qui demande huit secondes au lieu de cinq, ou un travelling avant qui coupe la tête du personnage. Pour les storyboards que tu as déjà exécutés, saute la passe mouvement et va directement à Turbo.
Durée : compte en minutes, pas en secondes
Les images GPT Image 2.5 Flare ont pris environ 27 secondes chacune lors de nos tests de septembre 2026. Seedance 2.5 est plus lent que ne le laisse penser sa fiche technique. Lors de notre test en conditions réelles, un clip Turbo image-vidéo de 4 secondes en 720p a pris environ neuf minutes entre l'envoi et le fichier terminé pendant la semaine de lancement, en grande partie, semble-t-il, en temps d'attente côté fournisseur. Compte 10 à 20 minutes pour une exécution complète et fais autre chose pendant ce temps. Tu peux fermer l'onglet : Canvas continue de tourner et les résultats arrivent dans les nœuds.
Comparatif des générateurs de storyboard IA
Ces outils recoupent le workflow Storyboard to Film de différentes façons. Les fonctions citées ci-dessous ont été vérifiées sur les pages publiques des éditeurs en septembre 2026 ; quand un éditeur n'indique pas publiquement un point, le tableau le dit.
| Outil | Images | Transforme les images en vidéo | Cohérence du personnage | Notes |
|---|---|---|---|---|
| MakeInfluencer.ai Storyboard to Film | GPT Image 2.5 Flare ou Sunburst, Nano Banana Pro, d'autres | Oui, dans la même exécution : Seedance 2.5, Seedance 2.5 Turbo, Wan 3.0, Kling 3.0, Gemini Omni | Ton influenceur IA ou une photo de référence, fournie à chaque image | Tableau de bord, Canvas, API REST, MCP ; coût en crédits affiché avant chaque exécution |
| Higgsfield Popcorn | Modèle de storyboard propre, jusqu'à 8 images, jusqu'à 4 références | Les images servent d'images de départ à des modèles vidéo distincts comme Kling ou Veo | Références plus génération de séquence cohérente | App ; crédits affichés avant la génération |
| LTX Studio | Script découpé en scènes et en plans ; images FLUX ou Nano Banana | Oui : ses propres modèles, plus des modèles partenaires que les avis indépendants disent inclure Kling, Seedance et Veo | Personnages et objets enregistrés comme « Éléments » réutilisables | App conçue pour la prévisualisation et les pitchs |
| Boords | Croquis, vectoriel ou images photoréalistes à partir d'un script | Pas de clips vidéo ; animatiques avec audio pour le rythme | Nomme la distribution, les lieux et les accessoires une fois, puis référence-les avec @ | Conçu pour les agences et les équipes de marque |
| StoryboardHero | Images avec titre, description, action et voix off par image | Export d'animatique MP4, pas de vidéo générée | Pas une fonction phare sur ses pages publiques | Orienté marketing et vidéo sociale |
Comment lire ce tableau : si tu as seulement besoin d'un storyboard à montrer à un client, Boords et StoryboardHero sont spécialisés pour cela et offrent des outils de relecture que les autres n'ont pas. Si tu veux un outil de film de bout en bout avec une timeline, LTX Studio est le plus complet. Higgsfield Popcorn produit des storyboards plus longs (jusqu'à huit images) avec une forte cohérence dans l'app, mais confie l'animation à une étape distincte. L'avantage du template Storyboard to Film pour les créateurs est plus étroit et plus précis : le storyboard part d'un personnage que tu possèdes déjà, les images et les clips vivent dans un seul graphe, et chaque nœud peut être remplacé par n'importe quel modèle de la plateforme.
Pour une vue plus large de l'offre de Higgsfield, consulte le guide des alternatives à Higgsfield. Pour les compromis entre modèles vidéo en général, lis les meilleurs générateurs vidéo IA en 2026.
La version en un clic : Storyboard to Film dans AI Canvas
Le template Storyboard to Film relie tout ce qui précède dans une seule exécution. Ouvre AI Canvas, choisis le template parmi les templates de réalisateur, dépose ton brief dans le premier nœud et ton personnage dans le second, puis appuie sur Exécuter.
Ce qui s'exécute, précisément :
- 1 nœud de brief d'histoire, prérempli avec un modèle à compléter pour l'histoire, le décor, les costumes et l'ambiance.
- 1 nœud de personnage, relié à chaque nœud d'image comme référence de visage.
- 4 nœuds LLM de rédacteur de plans, chacun avec le prompt système du réalisateur et sa propre consigne de temps (établissement, action, gros plan, résolution), température 0,8, jusqu'à 160 tokens.
- 4 nœuds d'image GPT Image 2.5 Flare en 16:9, 1K, qualité moyenne, une sortie chacun.
- 4 nœuds de clip Seedance 2.5 Turbo en 720p, cinq secondes, audio activé. Chacun reçoit son image comme image de départ et sa description de plan comme prompt.
Chaque nœud est modifiable. Changements courants :
- Règle un nœud de clip sur Seedance 2.5 Standard et 1080p pour le plan héros.
- Passe la durée à 8 ou 10 secondes sur le plan d'action.
- Bascule un nœud d'image sur GPT Image 2.5 Sunburst quand tu as besoin d'une retouche précise d'une image existante plutôt que d'une image neuve.
- Règle la qualité de l'image sur haute quand tu veux une image de qualité affiche.
- Modifie le prompt système du réalisateur sur les quatre rédacteurs de plans pour changer le style maison, par exemple « documentaire, caméra à l'épaule, lumière disponible ».
Valide le storyboard avant de lancer les clips
Exécute le template une fois, examine les quatre images et ne régénère que celles qui sont ratées. Chaque clip lit l'image actuelle : corriger une image et relancer son clip coûte donc un clip, pas quatre.
Au-delà de quatre plans
Quatre plans, c'est une forme de départ, pas une limite. Pour aller plus loin :
- Plus de plans. Duplique une chaîne rédacteur de plans, image et clip, et donne au nouveau rédacteur sa propre consigne (« Écris le PLAN 5, la réaction d'un deuxième personnage… »). Relie-lui les nœuds de brief et de personnage.
- Plans plus longs. N'importe quel clip peut aller jusqu'à 30 secondes sur Seedance 2.5. Au-delà, utilise Seedance 2.5 Video Extend via l'API pour prolonger un clip à partir de ses 30 dernières secondes.
- Plusieurs scènes. Exécute le template une fois par scène, avec un brief propre à la scène et le même personnage. Garde les lignes de costumes et d'ambiance identiques d'un brief à l'autre.
- Formats verticaux. Passe les nœuds d'image en 9:16. Les clips image-vidéo suivent le format de l'image de départ : toute la chaîne passe donc en vertical pour Reels et TikTok.
Construire le même pipeline via l'API
Tout ce qui figure dans le template est disponible via l'API REST de MakeInfluencer.ai, ce qui est utile pour générer de nombreux storyboards à partir d'un tableur de briefs. Le déroulé est le suivant :
- Génère chaque image avec
gpt-image-2.5-flare, en passant l'image de ton personnage dansimageUrls. - Interroge
/generations/image/{id}jusqu'à ce queterminalsoit vrai, puis récupère l'URL. - Soumets chaque clip à
seedance25turboavec l'URL de l'image commestartFrameUrl. L'API choisit automatiquement le mode image-vidéo quand une image de départ est présente. - Interroge
/generations/video/{id}jusqu'à ce queterminalsoit vrai.
Le guide de l'API Seedance 2.5 donne des exemples complets de requêtes et de réponses, et la page de l'API GPT Image 2.5 Flare liste chaque paramètre d'image. Les crédits sont partagés entre le tableau de bord, Canvas et l'API, et preview-credits renvoie le coût exact de n'importe quelle requête sans rien facturer.
Questions fréquentes
Qu'est-ce qu'un générateur de storyboard IA ?
Un outil qui transforme un script ou un brief en une séquence d'images fixes, une par plan, pour que tu puisses planifier et valider une vidéo avant de la produire. Les outils storyboard-vers-vidéo comme le template Storyboard to Film ajoutent l'étape de production : chaque image validée est animée en clip.
Puis-je faire un court métrage IA de cette façon ?
Oui. Une exécution produit quatre clips de cinq secondes, soit une séquence de 20 secondes avec un personnage et un arc complet. Allonge les durées, ajoute des chaînes de plans ou exécute le template une fois par scène pour des films plus longs. Aucun modèle vidéo actuel ne produit un film entier en une seule passe ; des courts métrages d'une à trois minutes sont réalistes avec plusieurs exécutions et un logiciel de montage.
Quel modèle choisir pour les images de storyboard : GPT Image 2.5 ou Nano Banana Pro ?
GPT Image 2.5 Flare suit plus précisément les consignes de cadrage et coûte 0,039 $ par image avec référence, contre 0,14 $ pour Nano Banana Pro. Nano Banana Pro tient parfois mieux un visage identique sur de nombreuses images. Essaie les deux sur le plan un et garde celui qui convient à ton personnage. La comparaison GPT Image 2.5 vs Nano Banana Pro va plus loin.
Le personnage reste-t-il cohérent sur les quatre clips ?
L'image de référence du personnage entre dans chaque image, et Seedance 2.5 anime l'image exacte qu'on lui donne : la ressemblance tient donc bien mieux qu'en partant du texte seul. Ce n'est pas parfait : ce sont les tours de tête et les très petits visages qui dérivent le plus. Vérifie les quatre images côte à côte et régénère toute image dont le visage est raté avant de lancer son clip.
Combien de temps prend une exécution ?
Chaque image prend environ une demi-minute. Les clips prennent plus de temps : lors de notre test de la semaine de lancement, un seul clip Seedance 2.5 Turbo a pris environ neuf minutes. Prévois 10 à 20 minutes par exécution.
Puis-je transformer mes propres croquis de storyboard en vidéo ?
Oui, avec une étape de plus. Ajoute un nœud d'entrée d'image avec ton croquis, relie-le à un nœud d'image et demande à GPT Image 2.5 Sunburst de le rendre photoréaliste avec ta référence de personnage, en gardant la composition. Anime ensuite l'image obtenue. Animer directement un croquis au crayon avec un modèle vidéo donne plutôt un croquis qui bouge, ce qui est rarement ce que tu veux.
Ça coûte combien ?
Environ 4,16 $ au tarif public des fournisseurs pour l'exécution par défaut de quatre images et quatre clips, affiché en crédits sur le bouton Exécuter avant le lancement. Les images en représentent environ 4 %. Passer les quatre clips à Seedance 2.5 standard en 720p porte le total à environ 7,36 $.
Y a-t-il un moyen gratuit d'essayer ?
Pas pour le template complet : les images et les clips consomment des crédits, et les nouveaux comptes ne reçoivent pas de crédits gratuits ; consulte donc la page tarifaire pour les plans actuels. Ce que tu peux faire gratuitement, c'est esquisser des images isolées avec l'aperçu de la page du générateur de storyboard IA, qui fait tourner notre propre modèle d'image ouvert sans compte. Le rendu n'égalera pas les images GPT Image 2.5, mais cela suffit pour tester le cadrage et l'objectif avant de dépenser des crédits.
Lance ton premier storyboard
Crée un compte et choisis un plan
Inscris-toi sur MakeInfluencer.ai et choisis un plan ou un pack de crédits sur la page tarifaire.
Ouvre AI Canvas et choisis Storyboard to Film
Colle un brief d'un seul paragraphe avec histoire, décor, costumes et ambiance, choisis ton personnage, puis appuie sur Exécuter.
Valide les images, puis termine les clips
Régénère toute image ratée, passe le plan héros en Seedance 2.5 Standard et monte les quatre clips ensemble avec une seule piste de musique.
Ouvre AI Canvas pour exécuter le template, essaie des plans isolés dans le générateur vidéo IA, ou lis le guide de l'API Seedance 2.5 pour construire le même pipeline en code. Une question ? Écris à [email protected].