Publicado em 29 de setembro de 2026. Os preços dos modelos são os preços de lista dos provedores naquela data, obtidos da mesma tabela de preços que alimenta a calculadora de créditos do MakeInfluencer.ai. A plataforma mostra o custo exato em créditos antes de cada execução.
A maioria dos vídeos com IA falha no mesmo lugar. Você escreve um prompt longo, espera a renderização e recebe um clipe onde o rosto se moveu, o enquadramento está errado e a iluminação mudou no meio do caminho. Depois você tenta novamente, e cada nova tentativa gasta créditos de vídeo, que são o tipo mais caro.
Cineastas resolveram esse problema muito antes dos modelos generativos existirem. Eles desenham um storyboard: um frame fixo por plano, aprovado antes de qualquer um ligar a câmera. A mesma disciplina funciona para vídeo com IA, e funciona melhor agora que dois modelos são particularmente bons em cada metade do trabalho. OpenAI GPT Image 2.5 desenha frames precisos e consistentes por alguns centavos cada. ByteDance Seedance 2.5 anima um frame finalizado em um clipe com áudio nativo e sincronizado, mantendo o que o frame estabeleceu.
Este guia é a versão longa. Ele aborda como escrever uma shot list que um modelo possa seguir, como manter um personagem estável entre frames, o vocabulário de câmera que realmente muda o resultado, padrões de prompt para cada tipo de plano, um exemplo completo do briefing aos quatro clipes finalizados com cada prompt mostrado, análise de custos linha por linha, um fluxo de trabalho barato de rascunho e uma comparação honesta com outros geradores de storyboard com IA. A última parte mostra a versão de um clique: o template Storyboard to Film em AI Canvas.

O que um gerador de storyboard com IA realmente faz
Um gerador de storyboard com IA transforma um script ou um briefing curto em uma sequência de frames fixos, um por plano, para que você possa ver e aprovar um vídeo antes de produzi-lo. Ferramentas mais antigas paravam por aí: desenhavam esboços ou ilustrações estilo stock para uma reunião com cliente. A nova geração de ferramentas storyboard-para-vídeo adiciona a etapa de produção. Cada frame aprovado se torna o frame inicial de um clipe de vídeo, então o board não é um plano para o filme, é a primeira metade do filme.
Essa mudança importa porque modelos de imagem e modelos de vídeo falham de formas diferentes. Modelos de imagem são bons em composição, guarda-roupa, rostos e iluminação, e são baratos de re-executar. Modelos de vídeo são bons em movimento e som, mas quando você pede a eles para inventar a composição também, eles gastam sua capacidade adivinhando, e pequenos erros se compõem ao longo de cinco ou dez segundos. Um storyboard divide o problema: o modelo de imagem decide como o plano se parece, e o modelo de vídeo apenas decide como se move.
Por que storyboard primeiro
Um storyboard com IA é um briefing de produção, não um moodboard. Cada frame responde duas perguntas: o que deve permanecer fixo (o personagem, guarda-roupa, cenário, iluminação) e o que vai se mover (uma ação, um movimento de câmera). Quando o frame é aprovado, o modelo de vídeo tem muito pouco deixado para inventar.
Três efeitos práticos seguem:
- Você fixa o visual antes de gastar créditos de vídeo. Um frame GPT Image 2.5 Flare com referência de personagem, em 1K e qualidade média, custa $0,039 ao preço de lista. Um clipe Seedance 2.5 Turbo de cinco segundos em 720p custa $1,00. O frame é aproximadamente 25 vezes mais barato, então itere ali.
- A mesma referência alimenta cada plano. A imagem de referência do seu personagem entra em cada frame, então o rosto se mantém consistente em toda a sequência em vez de derivar de plano para plano.
- Você regenera um frame ou um clipe, não a sequência inteira. Se o plano três está errado, re-execute apenas o plano três.
Os dois modelos e por que funcionam bem juntos
GPT Image 2.5 Flare (frames)
Modelo de imagem de setembro de 2026 da OpenAI. Mais nítido que GPT Image 2 com cerca de metade da latência, forte em seguimento de framing e instruções, e aceita até 16 imagens de referência, que é como o personagem permanece consistente. Frames levaram cerca de 27 segundos cada em nossos testes.
Seedance 2.5 (clipes)
Modelo de vídeo flagship da ByteDance, lançado em 31 de julho de 2026. Anima um frame inicial em um clipe de 4 a 30 segundos com áudio sincronizado, mantém o assunto, guarda-roupa e iluminação do frame, e oferece um frame final opcional. Nível Turbo para rascunhos, nível padrão para finais.
GPT Image 2.5 vem em dois sabores no MakeInfluencer.ai. Flare é o modelo de geração que o template usa. Sunburst é ajustado para edições precisas que preservam rostos, produtos e layouts, o que o torna a ferramenta certa quando você quer mudar uma coisa sobre um frame aprovado (trocar a cor da jaqueta, mover o personagem para a esquerda) sem redesenhar o resto.
O Seedance 2.5 também vem em dois níveis. Seedance 2.5 Turbo roda em 720p ou 1080p por $0,20 ou $0,22 por segundo. O Seedance 2.5 padrão roda de 480p a 4K e custa $0,36 por segundo em 720p. Ambos levam o mesmo prompt e o mesmo frame inicial, então mover um plano de rascunho para final é uma troca de modelo, não uma reescrita.
Você pode trocar qualquer metade. O Nano Banana Pro do Google é um forte modelo de frame quando um rosto idêntico em muitos frames é mais importante que composição precisa, embora custe $0,14 por frame. Wan 3.0 da Alibaba é o jeito mais barato de animar em 720p, a $0,10 por segundo. O template usa GPT Image 2.5 Flare e Seedance 2.5 Turbo como padrão porque esse par oferece a melhor precisão de frame por dólar e melhor movimento por dólar até o momento da escrita.
Uma nota sobre Sora 2
OpenAI descontinuou a API Sora 2 Videos em 24 de setembro de 2026. Tutoriais de storyboard mais antigos que animam frames com Sora 2 não funcionam mais através de nenhuma API. Seedance 2.5, Wan 3.0, Kling 3.0 e Veo 3.1 Fast são as opções práticas para animar frames de storyboard hoje.
Construção de shot list: a parte que a maioria dos storyboards com IA pula
Antes de qualquer modelo executar, você precisa de uma shot list: o conjunto ordenado de planos, o que cada um mostra e por que existe. A maioria dos curtas decepcionantes com IA não são falhas de modelo. São quatro imagens bonitas sem razão para estar naquela ordem.
A estrutura de quatro tempos
O template usa uma estrutura de quatro tempos emprestada da publicidade de formato curto e exercícios de escola de cinema. É pequena o suficiente para produzir em uma sessão e completa o suficiente para se parecer com uma história.
| Plano | Função | Enquadramento | O que o espectador aprende |
|---|---|---|---|
| 1. Establishing | Mostrar o mundo | Amplo, foco profundo, personagem pequeno a médio no frame | Onde estamos, que hora é, qual é o clima |
| 2. Ação | Mostrar o evento principal | Médio, cintura acima, um claro movimento físico | O que o personagem quer e faz |
| 3. Close-up | Mostrar o sentimento | Rosto e mãos, foco raso | Como o personagem se sente sobre o que aconteceu |
| 4. Resolução | Fechar o loop | Mais amplo ou estático, segura por um tempo | Onde o personagem termina; o clima mudou |
A progressão de amplo para médio para perto e de volta para fora não é decoração. É como editores mantiveram audiências orientadas por um século. Um plano amplo diz ao espectador onde ele está. Cortar mais perto diz o que importa. Recuar no final dá espaço para sentir o final. Se você quebra o padrão, faça deliberadamente: uma história que abre com um close-up de mãos e apenas revela a sala no plano dois pode funcionar, mas apenas se o briefing pedir isso.
Uma ação por plano
Um clipe de cinco segundos aguenta uma ação. "Ela se vira, caminha até a porta, abre-a e olha para trás" são quatro ações e sairá como um borrão apressado ou um clipe que para no meio. "Ela abre a porta com o ombro" é uma ação que um modelo de vídeo pode animar de forma limpa em cinco segundos. Se sua história precisa de mais, precisa de mais planos ou de uma duração maior naquele plano.
Um teste útil: descreva o plano para um amigo em uma frase que contém um verbo de movimento. Se você precisa de "e depois", divida.
Regras de continuidade para anotar
Continuidade é o que um storyboardista humano faz sem pensar e um modelo não faz de jeito nenhum. Anote essas regras no briefing, uma vez, e o redator de planos as levará em cada plano:
- Guarda-roupa. Nomeie cada peça de roupa visível e sua cor. "Jaqueta de chuva amarela, calças cargo pretas, bolsa de correio cinza cruzada no peito."
- Hora e clima. "Noite, chuva leve, chão molhado." Se está chovendo no plano um e seco no plano três, a sequência desmorona.
- Fonte de luz. "Sinalização de néon é a luz principal." Isso mantém a cor da luz consistente.
- Direção de tela. Se o personagem se move da esquerda para a direita no plano dois, ele não deveria chegar da direita no plano quatro a menos que se virou. Diga "ela se move da esquerda para a direita por todo o filme" se a direção importa.
- Props. A encomenda no plano dois deve ser a mesma encomenda no plano quatro.
O que deixar de fora do briefing
Deixe o diálogo de fora, porque um frame não pode carregá-lo e induz o modelo de vídeo a mexer a boca que não combinará com nenhum áudio. Deixe de fora texto na tela e nomes de marca, porque texto em frames gerados é pouco confiável e logos criam problemas de direitos. Deixe também o jargão de câmera fora do briefing: o redator de planos adiciona a lente e luz por plano, e um briefing que diz "anamórfico 35mm" vai empurrar cada plano para o mesmo enquadramento.
Consistência de personagem entre frames
Consistência é a razão para usar um fluxo de trabalho de storyboard, então merece sua própria seção. Existem três camadas, e você quer todas as três.

Camada 1: uma imagem de referência limpa
Cada frame recebe a mesma imagem de referência do personagem. A referência deve ser um retrato bem iluminado, de frente ou três quartos com o rosto desobstruído, expressão neutra, e idealmente o guarda-roupa que você quer no filme. Uma foto de referência usando uma camiseta branca conflita com um briefing que pede uma jaqueta amarela; o modelo tem que decidir em qual acreditar, e não vai decidir do mesmo jeito a cada vez.
Se você já tem um influenciador IA no MakeInfluencer.ai, o nó de personagem puxa sua imagem de referência diretamente. Se você não tem, carregue um retrato limpo. O guia de personagem IA consistente aborda como criar uma referência que se sustente em muitas cenas, e o guia de consistência de personagem explica os compromissos entre imagens de referência e modelos treinados.
Camada 2: o bloqueio de identidade no prompt
A referência sozinha não é suficiente; o prompt tem que dizer ao modelo de imagem o que fazer com ela. O prompt de frame do template diz, em sua segunda frase: "A pessoa na imagem de referência é o personagem principal: mantenha rosto, cabelo, tom de pele e construção idênticos à referência." Essa instrução classifica a referência acima de qualquer coisa na descrição do plano, que é o que você quer quando o redator de planos descreve o personagem vagamente.
Camada 3: o frame é a referência para o clipe
Quando Seedance 2.5 anima um frame, o frame é a imagem inicial. O modelo começa a partir daqueles exatos pixels, então qualquer identidade que o frame tenha, o primeiro frame do clipe tem também. A deriva no clipe vem do movimento: uma volta de cabeça que revela um perfil que o frame nunca mostrou, ou um close-up que inventa detalhe. O prompt do clipe combate isso com "mantenha o personagem, guarda-roupa, cenário e iluminação exatamente como no frame" e pedindo um movimento de câmera, não três.
Verifique rostos antes de animar
Coloque os quatro frames lado a lado e olhe apenas para o rosto. Se o rosto de um frame está errado, regenere aquele frame antes do clipe executar. Corrigir um rosto em um frame de $0,039 é sempre mais barato do que descobrir em um clipe de $1,00.
O que ainda dá errado
Não é perfeito. As falhas que você verá mais frequentemente:
- Planos de perfil. Uma referência frontal não diz ao modelo como o perfil do personagem se parece. Se um plano precisa de perfil, adicione uma segunda imagem de referência tirada do lado.
- Rostos muito pequenos. Em um establishing amplo, o rosto pode ter 40 pixels de altura. O modelo tem menos para combinar e deriva mais. Isso geralmente é aceitável em um amplo; o espectador lê a silhueta e guarda-roupa.
- Mãos e props. Mãos segurando objetos ainda são um ponto fraco para modelos de imagem e vídeo. Mantenha ações de mão simples: segurando, colocando, empurrando. Evite qualquer coisa que precise de dedos interagindo precisamente.
Linguagem de câmera que muda o resultado
Ambos os modelos entendem vocabulário cinematográfico padrão, mas nem todo termo tem efeito. Estes são os que mudam confiável o que você recebe.

Termos de enquadramento (para o modelo de frame)
| Termo | O que GPT Image 2.5 faz com isso | Use para |
|---|---|---|
| Extremamente amplo / establishing amplo | Personagem pequeno, ambiente dominante | Plano 1 |
| Plano completo | Cabeça a pé no frame | Mostrando guarda-roupa e postura |
| Plano médio / cintura acima | Torso e mãos, rosto legível | Plano 2, maioria das ações |
| Plano médio-close-up | Peito acima | Reações com algum contexto |
| Close-up | Rosto preenche a maioria do frame | Plano 3 |
| Sobre-o-ombro | Ombro em primeiro plano, assunto além | Cenas de dois personagens |
| Ângulo baixo | Câmera abaixo da linha dos olhos, assunto parece forte | Momentos de resolução |
| Ângulo alto | Câmera acima, assunto parece pequeno | Isolamento, derrota |
Comprimento de lente é um atalho útil para perspectiva. "24mm" te dá uma visão ampla e ligeiramente distorcida com muito ambiente. "35mm" é o padrão de narrativa natural. "50mm" é próximo da visão humana. "85mm" comprime o fundo e isola um rosto. O modelo não simula ótica exatamente, mas esses números movem o enquadramento na direção que você espera.
Termos de movimento (para o modelo de vídeo)
| Termo | O que Seedance 2.5 faz com isso | Bom para |
|---|---|---|
| Slow push-in | Câmera se move em direção ao assunto | Construindo tensão, ênfase |
| Pull-out / dolly back | Câmera se afasta | Finais, revelações |
| Tracking shot / follow | Câmera se move com o assunto | Caminhando, correndo |
| Pan esquerda ou direita | Câmera gira em seu eixo | Revelando um espaço |
| Tilt para cima ou para baixo | Câmera gira verticalmente | Revelando altura |
| Handheld | Pequeno agito orgânico | Urgência, sensação de documentário |
| Locked-off / estático | Nenhum movimento de câmera | Deixando a ação carregar o plano |
| Orbit | Câmera circunda o assunto | Momentos de herói, usado com moderação |
A regra mais útil: um movimento de câmera por plano. "Slow push-in enquanto faz pan para esquerda e tilt para cima" pede ao modelo para resolver três movimentos ao mesmo tempo e geralmente vai fazer um deles mal. Se um plano precisa de um movimento complexo, provavelmente precisa ser dois planos.
A segunda regra: combine o movimento da câmera com a função do plano. Um plano establishing quer um pan lento ou um push-in lento, que dá ao espectador tempo para ler o espaço. Um plano de ação quer um follow ou handheld. Um close-up quer nada ou um push-in muito lento. Um plano de resolução quer um pull-out ou um frame locked-off que deixa o momento respirar.
Padrões de prompt por tipo de plano
O template monta cada prompt de duas partes: a descrição do plano (escrita fresca por plano pelo LLM diretor) e uma spec fixa (idêntica para todos os quatro planos). Na canvas, a descrição do plano vem primeiro, depois uma linha em branco, depois a spec. Aqui está o que cada parte deve conter, com padrões reutilizáveis.
A spec de frame (fixa para todos os frames)
Este é o texto exato que o template adiciona a cada frame:
Photoreal cinematic storyboard frame in 16:9. The person in the reference image is the lead character: keep face, hair, skin tone and build identical to the reference. Anamorphic feel on a 35mm lens, motivated natural light, fine film grain, muted graded palette. Compose the frame so it can be animated into a five-second shot. Avoid: on-screen text, captions, logos, watermarks, split screens, extra people, distorted hands.
Duas frases fazem mais trabalho do que parecem. "Compose the frame so it can be animated" empurra o modelo longe de composições congeladas e super-posadas em direção a frames com espaço para movimento. "Split screens" na lista de evitar impede que GPT Image 2.5 ocasionalmente retorne um storyboard multi-painel em uma imagem, que é um modo de falha real quando a palavra "storyboard" está no prompt.
A spec de clipe (fixa para todos os clipes)
Animate this storyboard frame as the shot described above. Keep the character, wardrobe, set and lighting exactly as in the frame. One clear camera move, natural believable motion, ambient sound design that matches the scene, no music, no on-screen text.
"No music" é deliberado. Quatro clipes com quatro trilhas de música geradas diferentes não podem ser cortados juntos. Som ambiente (chuva, tráfego, passos, tom de sala) corta de forma limpa, e você pode colocar uma faixa de música sobre a sequência finalizada em qualquer editor.
Padrões de descrição de plano
Cada descrição de plano deve seguir a mesma forma de três frases: o que vemos e onde o personagem está; o que o personagem faz; enquadramento, lente, luz e clima. Esses padrões funcionam bem como pontos de partida:
Establishing amplo. "Wide shot of [lugar] at [hora], [clima]. [Personagem] is [pequeno ou médio] in frame, [uma ação tranquila que define o clima]. 24mm lens, deep focus, [fonte de luz] as the main light, [clima] atmosphere."
Ação média. "Medium shot, waist-up, of [personagem] [ação física única] in [parte do local]. [Um detalhe que mostra intenção ou stakes]. 35mm lens, [fonte de luz] from [direção], [palavra de energia] mood."
Close-up emocional. "Close-up of [personagem]'s face and hands as [a reação ou realização]. [Uma mudança de expressão]. 85mm lens, shallow depth of field, [luz motivada], [clima]."
Resolução. "[Enquadramento mais amplo ou estático] of [personagem] [posição final ou ação] in [local]. [Como o ambiente ou luz mudou desde o plano um]. [Lente], [luz], the mood has shifted to [novo clima]."
O prompt do sistema diretor que o template usa diz ao LLM para produzir apenas esse tipo de descrição de duas ou três frases, sem cabeçalhos, listas ou comentário, e nunca pedir texto, legendas ou logos. Você pode editá-lo em qualquer nó redator de planos.
Um exemplo completo do trabalho: briefing para quatro frames para quatro clipes
Aqui está uma execução completa, com cada prompt. Usa as configurações padrão do template: GPT Image 2.5 Flare em 16:9, 1K, qualidade média para frames, e Seedance 2.5 Turbo em 720p, cinco segundos, áudio ligado para clipes.
O briefing
Este é o único texto que você escreve:
Story: Mara, a 30-year-old courier, races the last delivery of the night through a rain-soaked market street and finds the shop already closed, then leaves the parcel on the step with a handwritten note tucked under the string. Setting: night market street, neon signage, light rain, wet cobblestones. Wardrobe: yellow rain jacket, black cargo trousers, grey courier bag across the chest. Tone: melancholic. Do not change the character's look between shots.
Por que funciona: um personagem, um local, um arco com um final, guarda-roupa nomeado uma vez, clima nomeado uma vez. Briefings com três locais ou dois personagens principais produzem boards que derivam, porque cada frame é gerado independentemente e a única coisa ligando-os é o texto e a referência.
As quatro descrições de plano
Cada um dos quatro nós redatores de plano recebe o briefing mais sua instrução de tempo. Uma saída típica se parece com isso (o LLM roda em temperatura 0,8, então a sua vai diferir na redação):
Plano 1, establishing. "Wide shot of a narrow night market street glistening with rain, shuttered stalls and pink and teal neon signs reflecting in the wet cobblestones. Mara, in her yellow rain jacket with the grey courier bag across her chest, is small in the middle distance, jogging toward camera between the stalls. 24mm lens, deep focus, neon as the main light, cold melancholic atmosphere."
Plano 2, ação. "Medium shot, waist-up, of Mara stopping short in front of a small shop with its metal shutter pulled down, one hand still gripping the brown paper parcel. Rain beads on her yellow hood and her breath shows in the cold air. 35mm lens, teal neon from the left, tense and deflated mood."
Plano 3, close-up. "Close-up of Mara's face and hands as she tucks a folded handwritten note under the string of the parcel, eyes lowered. A small, tired half-smile. 85mm lens, shallow depth of field, warm spill from a nearby lantern against the cold neon, quiet and tender."
Plano 4, resolução. "Static wide shot from across the street: the parcel sits alone on the shop's step under a small awning while Mara walks away to the right, her yellow jacket the only warm color in the frame. The rain has eased to a drizzle. 35mm lens, neon and lantern light, the mood has shifted from urgency to quiet acceptance."
Repare no que o LLM levou do briefing sem ser dito novamente: a jaqueta amarela, a bolsa cinza, o néon, a chuva. É por isso que o briefing os nomeia uma vez, claramente.
Os quatro frames
Cada nó de frame recebe sua descrição de plano, a spec de frame adicionada depois de uma linha em branco, e a imagem de referência de personagem. O prompt completo para o frame 2, exatamente como foi enviado, é:
Medium shot, waist-up, of Mara stopping short in front of a small shop with its metal shutter pulled down, one hand still gripping the brown paper parcel. Rain beads on her yellow hood and her breath shows in the cold air. 35mm lens, teal neon from the left, tense and deflated mood.

Photoreal cinematic storyboard frame in 16:9. The person in the reference image is the lead character: keep face, hair, skin tone and build identical to the reference. Anamorphic feel on a 35mm lens, motivated natural light, fine film grain, muted graded palette. Compose the frame so it can be animated into a five-second shot. Avoid: on-screen text, captions, logos, watermarks, split screens, extra people, distorted hands.
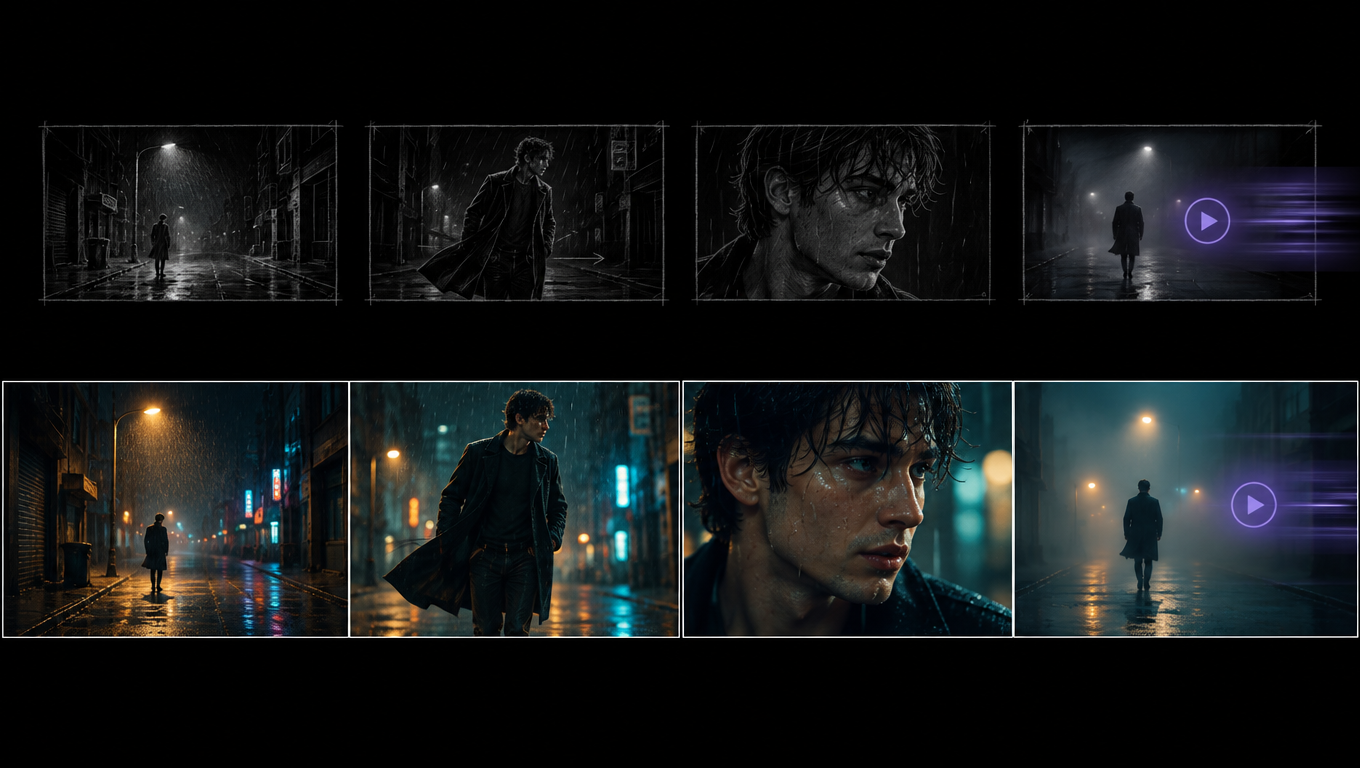
Revise os quatro frames contra uma checklist curta antes de qualquer clipe executar:
- O rosto é a mesma pessoa em todos os quatro?
- O guarda-roupa é idêntico, incluindo cores?
- A fonte de luz é consistente (néon aqui, não luz do dia)?
- Cada frame mostra exatamente uma ação, com espaço para animá-la?
- Há algum texto, logo ou pessoa extra que escapou?
Em uma execução típica, um frame a cada quatro precisa de uma segunda tentativa. O caso mais comum é o establishing amplo, onde o personagem é pequeno e o modelo às vezes adiciona figuras extras a uma rua de mercado. Execute de novo apenas aquele nó de frame; os outros três ficam como estão.
Os quatro clipes
Cada nó de clipe recebe o frame como seu frame inicial e a descrição do plano mais a spec de clipe como seu prompt. O prompt completo para o clipe 2 é:
Medium shot, waist-up, of Mara stopping short in front of a small shop with its metal shutter pulled down, one hand still gripping the brown paper parcel. Rain beads on her yellow hood and her breath shows in the cold air. 35mm lens, teal neon from the left, tense and deflated mood.

Animate this storyboard frame as the shot described above. Keep the character, wardrobe, set and lighting exactly as in the frame. One clear camera move, natural believable motion, ambient sound design that matches the scene, no music, no on-screen text.
Se você quer dirigir o movimento mais precisamente do que "one clear camera move", adicione uma linha ao prompt do nó de clipe. Para esta sequência:
| Clipe | Linha de movimento adicionada | Por quê |
|---|---|---|
| 1 | "Slow push-in as she jogs toward camera, footsteps splashing." | Puxa o espectador para dentro da rua |
| 2 | "Handheld, slight shake, she exhales and her shoulders drop." | Urgência desabando em desapontamento |
| 3 | "Locked-off, only her hands and eyes move." | Deixa o pequeno gesto carregar o plano |
| 4 | "Slow pull-out while she walks out of frame to the right." | Deixa a encomenda sozinha no final |
O clipe acima é uma renderização real de imagem para vídeo Seedance 2.5 Turbo de um dos frames do template. Quatro clipes em ordem fazem um filme de 20 segundos. Corte-os em qualquer editor, coloque uma única faixa de música abaixo, e você tem um curta com um personagem consistente, um local e um arco completo.
Corrigindo um clipe ruim
Se um clipe se comporta mal, diagnostique antes de re-executar:
- Rosto deriva no meio do clipe. Geralmente causado por uma volta de cabeça. Adicione "she keeps her face toward camera" ou escolha um movimento de câmera que não revele um novo ângulo.
- Muito acontece. A descrição do plano tem duas ações. Corte para uma.
- Nada acontece. O frame está pose demais. Regenere o frame com uma composição mais aberta, ou adicione uma linha de ação explícita ao clipe.
- Som errado. Nomeie o som: "rain on the awning, distant traffic, no voices."
- Clipe muito curto para a ação. Aumente a duração daquele nó para 8 ou 10 segundos. Seedance 2.5 aceita 4 a 30 segundos.
O que custa, linha por linha
Todos os valores abaixo são preços de lista de provedor do manifesto de preços do MakeInfluencer.ai, verificados em 29 de setembro de 2026. A coluna de créditos usa a conversão atual da plataforma; o botão Run em Canvas mostra o total exato antes de qualquer coisa começar.
| Etapa | Modelo e configurações | Contagem | Preço de lista cada | Créditos aprox. cada |
|---|---|---|---|---|
| Escrita de plano | Director LLM | 4 | uma fração de centavo | 1.000 |
| Frames | GPT Image 2.5 Flare, 1K médio, com referência de personagem | 4 | $0,039 | 1.955 |
| Clipes | Seedance 2.5 Turbo, 720p, 5 s, áudio ligado | 4 | $1,00 | 50.126 |
| Total por Execução | cerca de $4,16 | cerca de 212.000 |
Frames com referência de personagem usam o preço de edição GPT Image 2.5 ($0,039 em 1K médio) em vez de seu preço texto-para-imagem simples ($0,024), porque a imagem de referência é uma entrada. Cada referência adicional além da primeira adiciona $0,015.
Os clipes são 96% da conta. Este é o argumento inteiro para aprovar o board primeiro.
Caminhos de upgrade e downgrade
| Mudança | Novo custo de clipe (5 s) | Total quatro-clipes | Quando vale a pena |
|---|---|---|---|
| Padrão: Seedance 2.5 Turbo 720p | $1,00 | $4,00 | Rascunhos, cortes sociais |
| Seedance 2.5 Turbo 1080p | $1,10 | $4,40 | Corte final para a maioria das plataformas |
| Seedance 2.5 padrão 720p | $1,80 | $7,20 | Planos de destaque com movimento complexo |
| Seedance 2.5 padrão 1080p | $4,50 | $18,00 | Entregas para clientes |
| Wan 3.0 720p | $0,50 | $2,00 | Execuções econômicas, movimento simples |
| Kling 3.0 Pro com som | $0,84 | $3,36 | Quando você prefere o estilo de movimento de Kling |
| Gemini Omni 1.1 Flash 360p | $0,15 | $0,60 | Testes de movimento apenas |
Uma configuração mista sensata: Turbo 720p nos planos 1, 3 e 4, standard Seedance 2.5 em 720p no plano de ação. Isso é $4,80 para os clipes, e o gasto extra vai para onde o movimento é mais difícil.
No lado do frame, aumentar a qualidade para alta em 1K custa $0,105 por frame com referência, ainda trivial perto dos clipes. Use quando você planeja puxar um still de pôster de um frame.
O fluxo de trabalho de rascunho: teste movimento barato antes de você se comprometer
O Seedance 2.5 Turbo já é o nível econômico, mas, para um board que você pretende iterar muito, existe uma primeira passada ainda mais barata. Gemini Omni 1.1 Flash do Google renderiza clipes de 3 a 10 segundos em 360p por $0,03 por segundo, então um teste de movimento de cinco segundos custa $0,15, cerca de 7.500 créditos. Suporta frames iniciais e tem áudio sempre ligado.
O fluxo de trabalho, que algumas plataformas vendem como um recurso de "modo de rascunho", tem apenas três etapas:
Etapa de frames
Execute apenas o briefing, redatores de plano e frames. Aprove todos os quatro frames. Custo: cerca de $0,16 ao preço de lista.
Etapa de movimento em 360p
Defina cada nó de clipe para Gemini Omni 1.1 Flash em 360p, cinco segundos. Assista para movimentos de câmera que revelam ângulos ruins, ações que não cabem, e timing. Ajuste as linhas de movimento. Custo: $0,60 para quatro clipes.
Etapa final
Mude os nós de clipe de volta para Seedance 2.5 Turbo em 720p ou 1080p, ou standard Seedance 2.5 para o plano herói, e execute. Custo: $4,00 a $7,20 dependendo da mistura.
Uma ressalva honesta: um rascunho de 360p de um modelo diferente mostra a composição, ritmo e movimento de câmera, não sobre exatamente como Seedance 2.5 vai renderizar o movimento. Seu valor é pegar os erros que são independentes do modelo, como a ação que precisa de oito segundos em vez de cinco, ou o push-in que corta a cabeça do personagem. Para boards que você rodou antes, pule o pass de movimento e vá direto para Turbo.
Timing: planeje para minutos, não segundos
Frames GPT Image 2.5 Flare levaram cerca de 27 segundos cada em nossos testes de setembro de 2026. Seedance 2.5 é mais lento do que sua folha de especificações sugere. Em nosso teste ao vivo, um clipe imagem para vídeo Turbo de 4 segundos em 720p levou cerca de nove minutos da submissão ao arquivo finalizado durante a semana de lançamento, a maioria aparentemente tempo de fila no lado do provedor. Planeje para uma execução completa levar 10 a 20 minutos e faça outra coisa enquanto funciona. Você pode fechar a aba; Canvas continua rodando e resultados chegam nos nós.
Geradores de storyboard com IA comparados
Essas ferramentas se sobrepõem com o fluxo de trabalho Storyboard to Film de formas diferentes. Afirmações de recursos abaixo foram verificadas nas páginas públicas dos vendedores em setembro de 2026; onde um vendedor não declara algo publicamente, a tabela avisa.
| Ferramenta | Frames | Transforma frames em vídeo | Consistência de personagem | Notas |
|---|---|---|---|---|
| MakeInfluencer.ai Storyboard to Film | GPT Image 2.5 Flare ou Sunburst, Nano Banana Pro, outros | Sim, na mesma Run: Seedance 2.5, Seedance 2.5 Turbo, Wan 3.0, Kling 3.0, Gemini Omni | Seu influenciador IA ou uma foto de referência, alimentada em cada frame | Dashboard, Canvas, REST API, MCP; custo de crédito mostrado antes de cada Run |
| Higgsfield Popcorn | Próprio modelo de storyboard, até 8 frames, até 4 referências | Frames são usados como frames iniciais para modelos de vídeo separados como Kling ou Veo | Referências mais geração de sequência consistente | App; créditos mostrados antes de geração |
| LTX Studio | Script dividido em cenas e planos; FLUX ou Nano Banana frames | Sim: próprios modelos de LTX, mais modelos de parceiros que revisões independentes listam como incluindo Kling, Seedance e Veo | Personagens e objetos salvos como "Elements" reutilizáveis | App construído para pre-vis e pitch decks |
| Boords | Esboço, vetor ou frames fotorreais de um script | Nenhum clipe de vídeo; animatics com áudio para timing | Nomeie elenco, localizações e props uma vez, referencie-os com @ | Construído para agências e equipes de marca |
| StoryboardHero | Frames com título, descrição, ação e voice-over por frame | Exportação MP4 animatic, não vídeo gerado | Não um recurso de destaque em suas páginas públicas | Orientado para vídeo de marketing e social |
Como ler isso: se você apenas precisa de um board para mostrar a um cliente, Boords e StoryboardHero são construídos para propósito e incluem ferramentas de revisão que os outros não têm. Se você quer uma ferramenta de filme end-to-end com uma timeline, LTX Studio é a mais completa. Higgsfield Popcorn produz boards mais longos (até oito frames) com forte consistência in-app mas entrega a animação para um passo separado. A vantagem do template Storyboard to Film para criadores é mais estreita e específica: o board é semeado de um personagem que você já possui, os frames e clipes rodam em um gráfico, e cada nó é intercambiável com qualquer modelo na plataforma.
Para uma olhada mais ampla no conjunto de ferramentas de Higgsfield, veja o guia alternativo de Higgsfield. Para compromissos de modelo de vídeo em geral, veja melhores geradores de vídeo IA em 2026.
A versão de um clique: Storyboard to Film em AI Canvas
O template Storyboard to Film coloca tudo acima em uma Run única. Abra AI Canvas, escolha o template dos templates de cineasta, solte seu briefing no primeiro nó e seu personagem no segundo, e pressione Run.
O que executa, exatamente:
- 1 nó de briefing de história, pré-preenchido com um template de preenchimento em branco para história, cenário, guarda-roupa e tom.
- 1 nó de personagem, conectado a cada nó de frame como referência de rosto.
- 4 nós de LLM redator de plano, cada um com o prompt do sistema diretor e sua própria instrução de tempo (establishing, ação, close-up, resolução), temperatura 0,8, até 160 tokens.
- 4 nós de frame GPT Image 2.5 Flare em 16:9, 1K, qualidade média, um output cada.
- 4 nós de clipe Seedance 2.5 Turbo em 720p, cinco segundos, áudio ligado. Cada um recebe seu frame como frame inicial e sua descrição de plano como prompt.
Cada nó é editável. Mudanças comuns:
- Defina um nó de clipe para standard Seedance 2.5 e 1080p para o plano herói.
- Aumente duração para 8 ou 10 segundos no plano de ação.
- Mude um nó de frame para GPT Image 2.5 Sunburst quando você precisa de uma edição precisa de um still existente em vez de um frame fresco.
- Defina qualidade de frame para alta quando você quer um still de qualidade pôster.
- Edite o prompt do sistema diretor em todos os quatro redatores de plano para mudar o estilo da casa, por exemplo "documentário, handheld, luz disponível".
Aprove o board antes de gerar os clipes
Execute o template uma vez, revise os quatro frames, e regenere apenas os que erram. Cada clipe lê o frame atual, então corrigir um frame e re-executar seu clipe custa um clipe, não quatro.
Indo além de quatro planos
Quatro planos é uma forma de partida, não um limite. Para estender:
- Mais planos. Duplique um redator de plano, um frame e a sequência de clipe, e dê ao novo redator de plano sua própria instrução de tempo ("Write SHOT 5, the reaction of a second character..."). Conecte os nós de briefing e personagem a ele.
- Planos mais longos. Qualquer clipe pode rodar até 30 segundos em Seedance 2.5. Além disso, use Seedance 2.5 Video Extend através da API para continuar um clipe a partir dos últimos segundos dele.
- Múltiplas cenas. Execute o template uma vez por cena com um briefing específico de cena e o mesmo personagem. Mantenha linhas de guarda-roupa e tom idênticas entre briefings.
- Cortes verticais. Mude nós de frame para 9:16. Clipes de imagem para vídeo seguem a forma do frame inicial, então a corrente inteira fica vertical para Reels e TikTok.
Construindo o mesmo pipeline através da API
Tudo no template está disponível através da API REST do MakeInfluencer.ai, o que é útil quando você quer gerar muitos boards de uma planilha de briefings. O fluxo é:
- Gere cada frame com
gpt-image-2.5-flare, passando sua imagem de personagem emimageUrls. - Consulte (polling)
/generations/image/{id}atéterminalser verdadeiro e pegue a URL. - Submeta cada clipe para
seedance25turbocom a URL do frame comostartFrameUrl. A API escolhe imagem para vídeo automaticamente quando um frame inicial está presente. - Consulte (polling)
/generations/video/{id}atéterminalser verdadeiro.
O guia de API Seedance 2.5 tem exemplos completos de request e response, e a página de API GPT Image 2.5 Flare lista cada parâmetro de frame. Créditos são compartilhados entre o dashboard, Canvas e a API, e preview-credits retorna o custo exato de qualquer request sem cobrar.
Perguntas frequentes
O que é um gerador de storyboard com IA?
Uma ferramenta que transforma um script ou briefing em uma sequência de frames fixos, um por plano, para que você possa planejar e aprovar um vídeo antes de produzi-lo. Ferramentas de storyboard para vídeo, como o template Storyboard to Film adicionam a etapa de produção: cada frame aprovado é animado em um clipe.
Posso fazer um curta com IA dessa forma?
Sim. Uma execução produz quatro clipes de cinco segundos, uma sequência de 20 segundos com um personagem e um arco completo. Aumente durações, adicione mais planos, ou execute o template uma vez por cena para filmes mais longos. Nenhum modelo de vídeo atual produz um longa-metragem de uma só vez; curtas de um a três minutos são realistas com várias execuções e um editor.
Qual é melhor para frames de storyboard, GPT Image 2.5 ou Nano Banana Pro?
GPT Image 2.5 Flare segue instruções de enquadramento mais precisamente e custa $0,039 por frame referenciado contra $0,14 para Nano Banana Pro. Nano Banana Pro às vezes é mais forte em manter um rosto idêntico entre muitos frames. Tente ambos no plano um e fique com o que combina melhor com seu personagem. A comparação GPT Image 2.5 vs Nano Banana Pro vai mais profundo.
O personagem permanece consistente entre os quatro clipes?
A referência de personagem vai em cada frame, e Seedance 2.5 anima o frame exato que é dado, então a semelhança se mantém bem melhor do que em vídeo gerado só a partir de texto. Não é perfeito: voltas de cabeça e rostos muito pequenos derivam mais. Verifique os quatro frames lado a lado e regenere qualquer frame onde o rosto está errado antes do clipe executar.
Quanto tempo leva uma execução?
Cada frame leva cerca de meio minuto. Clipes levam mais: em nosso teste de semana de lançamento, um clipe Seedance 2.5 Turbo levou cerca de nove minutos. Planeje para 10 a 20 minutos por execução.
Posso transformar meus próprios esboços de storyboard em vídeo?
Sim, com uma etapa extra. Adicione um nó de entrada de imagem com seu esboço, conecte-o a um nó de frame, e peça a GPT Image 2.5 Sunburst para renderizá-lo fotorrealista com sua referência de personagem, mantendo a composição. Depois anime o frame renderizado. Animar um esboço a lápis diretamente com um modelo de vídeo tende a produzir um esboço em movimento, que é raramente o que você quer.
Quanto custa?
Cerca de $4,16 ao preço de lista do provedor para a execução padrão de quatro frames e quatro clipes, mostrado em créditos no botão Run antes de você começar. Os frames representam cerca de 4% disso. Atualizar todos os quatro clipes para o Seedance 2.5 padrão em 720p aumenta o total para cerca de $7,36.
Há uma forma gratuita de tentar?
Não para o template completo: os frames e clipes rodam em créditos, e contas novas não vêm com créditos grátis, então verifique a página de preços para planos atuais. O que você pode fazer de graça é esboçar frames avulsos com a prévia na página do gerador de storyboard com IA, que roda nosso próprio modelo de imagem aberto sem uma conta. Não vai combinar com frames GPT Image 2.5, mas é suficiente para testar enquadramento e lente antes de você gastar créditos.
Comece seu primeiro board
Crie uma conta e escolha um plano
Cadastre-se no MakeInfluencer.ai e escolha um plano ou pacote de créditos na página de preços.
Abra AI Canvas e escolha Storyboard to Film
Cole um briefing de um parágrafo com história, cenário, guarda-roupa e tom, escolha seu personagem, e pressione Run.
Aprove os frames, depois termine os clipes
Regenere qualquer frame que erre, use o Seedance 2.5 padrão no plano de destaque, e corte os quatro clipes juntos com uma faixa de música.
Abra AI Canvas para executar o template, tente planos únicos no gerador de vídeo IA, ou leia o guia de API Seedance 2.5 para construir o mesmo pipeline em código. Perguntas: [email protected].