一貫性のあるAIインフルエンサーを作成する最速の方法は、1枚の参照写真から始めることです。詳細なプロンプトを書いてAIが何かを生成することを期待する代わりに、必要な顔の1〜20枚の画像から直接キャラクターをトレーニングします。システムはその特定の人物を学習し、その後生成するすべての画像や動画で同じ特徴、プロポーション、アイデンティティを維持します。
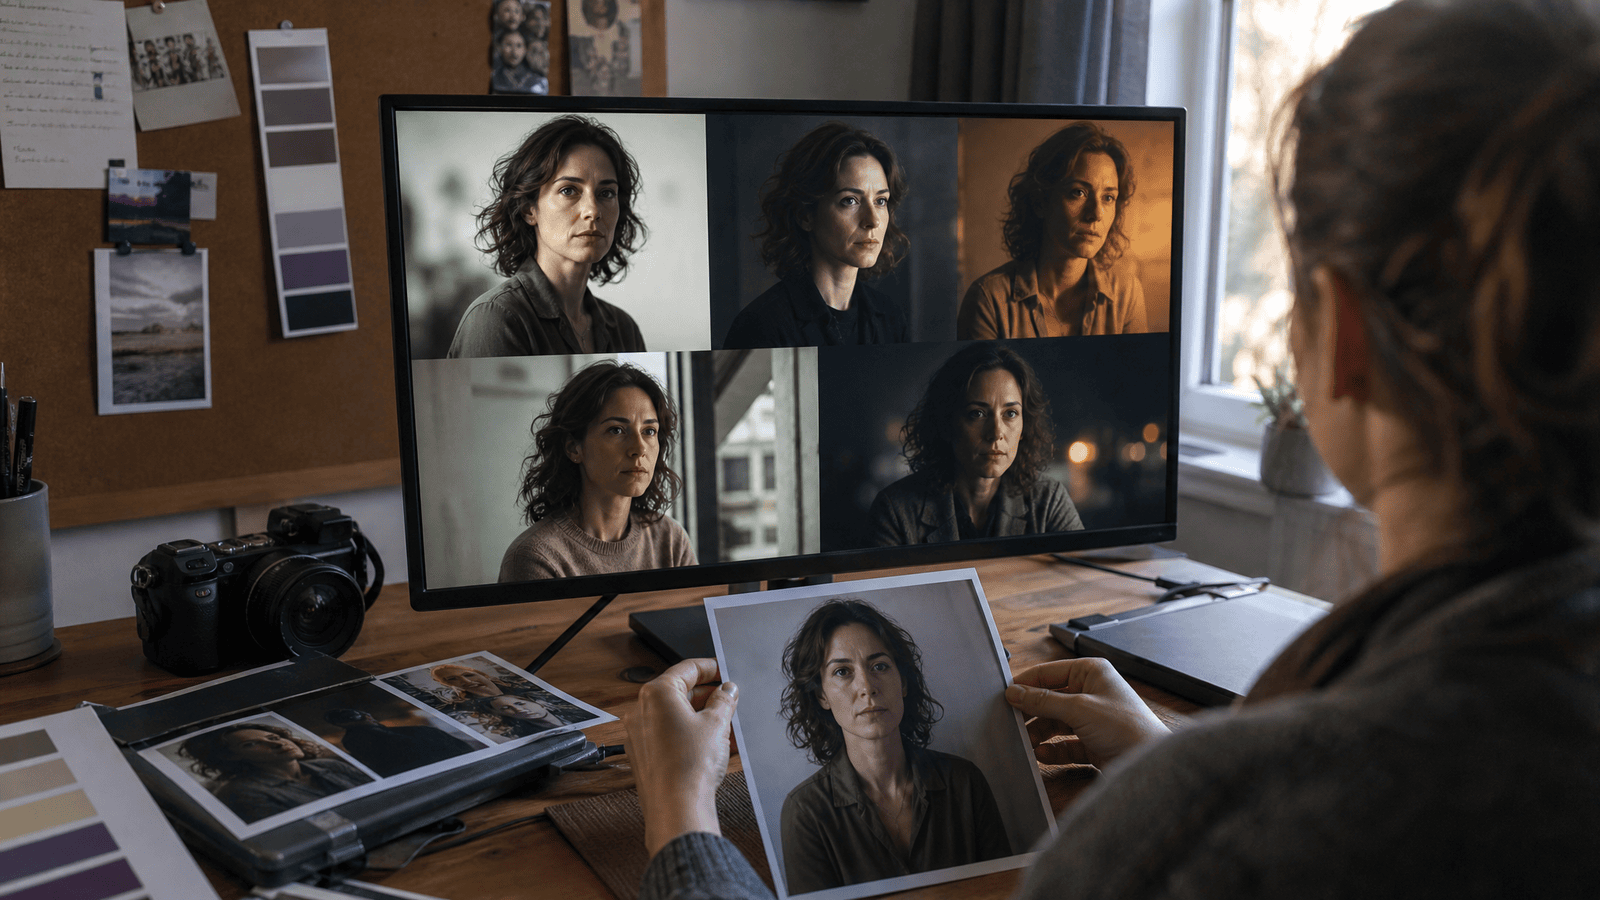
このガイドでは、参照写真の選択、トレーニングデータセットの準備、キャラクタートレーニングワークフローの実行、そして複数のAIモデルにわたる一貫性のあるコンテンツ生成という完全なプロセスを解説します。
テキストプロンプトではなく写真からトレーニングする理由
テキストから画像への生成は強力ですが、1つの根本的な制限があります。すべての生成が新しい解釈であることです。詳細なプロンプトを使用しても、微妙な顔の特徴が出力間で変化します。目が少し異なります。鼻の形が変わります。顎のラインが変わります。
参照写真からのトレーニングは、これを完全に解決します。
写真ベースのトレーニングの仕組み
テキストで顔を説明する代わりに、参照画像を提供することでAIに正確に何が欲しいかを示します。システムは顔の幾何学、肌の特徴、特徴的な特性、プロポーションを分析します。これらの特定の特性をエンコードしたキャラクターモデルを構築します。
新しい画像や動画を生成するとき、AIはゼロから新しい顔を作成する代わりに、そのトレーニング済みモデルを参照します。出力は、新しいポーズ、衣装、照明、シーンに適応しながら、トレーニング済みキャラクターのアイデンティティを維持します。
参照ベースの学習
AIはテキスト説明ではなく実際の画像から学習し、プロンプトでは説明不可能な詳細をキャプチャします。
固定されたアイデンティティ
顔のプロポーション、骨格構造、特徴的な特性がすべての生成で一貫性を保ちます。
柔軟な変化
同じ認識可能な顔を保ちながら、衣装、ポーズ、場所、照明を変更できます。
クロスモデル一貫性
トレーニング済みキャラクターを複数のAIモデル(画像生成、動画ツール、編集パイプライン)で使用できます。
結果は、実在の人物のように振る舞うAIインフルエンサーです。フォロワーは顔を即座に認識し、エンゲージメントは時間とともに構築され、コンテンツライブラリは散らばっているのではなく、まとまりのあるものに感じられます。
今日からキャラクタートレーニングを開始
MakeInfluencer.aiは、1〜20枚の参照写真からのキャラクタートレーニングをサポートし、完全なクロスモデル互換性を備えています。画像をアップロードし、トレーニングワークフローを実行し、数時間で一貫性のあるコンテンツの生成を開始します。アカウントを作成して、キャラクタートレーニングツールに即座にアクセスできます。
ステップ1:参照写真を選択する
トレーニング済みキャラクターの品質は、参照写真の品質に完全に依存します。1枚の画像から、または20枚もの画像からトレーニングできますが、それらの画像の構成と多様性が、AIがキャラクターをどれだけうまく学習するかを決定します。
何枚の写真が必要か?
1枚の写真 -- 最小限の実行可能なトレーニング。参照画像と類似した単純なポーズとアングルで機能します。柔軟性は限定的です。
3〜5枚の写真 -- ほとんどのクリエイターにとってのスイートスポット。AIが核となる特徴を学習するのに十分な顔の変化を提供しながら、データセットを管理可能に保ちます。
10〜20枚の写真 -- 最大の一貫性。AIは複数のアングル、照明条件、表情から顔を学習します。プロのインフルエンサーワークフローに最適です。
まずは3〜5枚の高品質画像から始めましょう。後でより良いカバレッジが必要な場合は、いつでもより多くの写真で再トレーニングできます。
良い参照写真とは何か
すべての写真がトレーニングに同じように適しているわけではありません。AIは、一貫した照明と最小限の歪みで、顔の明確で邪魔されないビューを必要とします。
技術要件:
- 解像度:最低512x512ピクセル。高いほど良いです -- 1024x1024以上を目指してください。
- フォーカス:顔の特徴に鮮明なフォーカス。ぼやけた、または低品質の画像は一貫性のない結果を生み出します。
- 照明:均一で自然な照明。強い影、極端な逆光、または色付きジェルを避けてください。
- 障害物:サングラス、マスク、顔を覆う手、または特徴を隠す濃いメイクはありません。
- ファイル形式:JPGまたはPNG。HEICファイルは自動的に変換されます。
アングルとポーズの多様性:
複数の写真でトレーニングする場合は、アングルと表情に多様性を含めてください:
- 正面向き:カメラとの直接のアイコンタクト、ニュートラルまたは笑顔。
- 四分の三ビュー:顔を横に30〜45度回転。
- プロフィール:鼻、顎のライン、耳を示す横向き。
- 異なる表情:ニュートラル、笑顔、笑い。特徴を歪める極端な表情を避けてください。
提供するアングルが多いほど、AIは顔の三次元構造をよりよく理解します。
参照写真のソース
オプション1:独自の参照顔を生成する
既存の写真がない場合は、MakeInfluencer.aiの画像モデルを使用してユニークな顔を生成することから始めます。Nano Banana ProまたはSeedreamを使用して、希望するキャラクターの3〜5枚の高品質なポートレート画像を作成し、それらの画像をトレーニングデータセットとして使用します。
このワークフローは、著作権の懸念がない完全にオリジナルのキャラクターを提供します。
オプション2:自分の写真を使用する
自分自身または使用許可を得た人のAIバージョンを作成したい場合は、個人の写真をアップロードしてください。画像の権利を所有しているか、描かれている人から明示的な同意を得ていることを確認してください。
オプション3:ストックおよびライセンス画像
商業利用権を持つロイヤリティフリーのストック写真またはライセンス画像を使用してください。ライセンスがAIトレーニングと派生作品を許可していることを確認してください。
著作権と同意が重要
許可なく実在の人物の写真からAIキャラクターをトレーニングしないでください。許可なく有名人の写真、インフルエンサーの画像、または著作権で保護された資料を使用することは、知的財産権とプラットフォームの利用規約に違反します。オリジナルの生成物、同意を得た個人写真、または適切にライセンスされた画像に限定してください。
ステップ2:トレーニングデータセットを準備する
参照写真を選択したら、トレーニング用に準備します。適切な準備はトレーニング品質を向上させ、エラーの可能性を減らします。
顔をトリミングして中央に配置する
一貫した背景が望ましい
トレーニングは、AIが気を散らすことなく顔に集中できる場合に最も効果的です。参照写真の背景が忙しいまたは乱雑な場合は、アップロードする前に簡単な背景除去ツールの使用を検討してください。
シンプルな背景(白、グレー、またはぼかし)により、AIは顔の特徴をより明確に学習できます。
重いフィルターと編集を避ける
Instagramフィルター、美容スムージング、または重い色調整が施された写真をアップロードしないでください。AIはトレーニング画像にあるすべての視覚的特性を学習します。heavily filteredな写真でトレーニングすると、AIはすべての生成でそれらの人工的な効果を再現しようとします。
最もクリーンな結果を得るには、自然な未編集の写真を使用してください。
ファイルを整理する
ファイルに明確な名前を付けます:ref-01.jpg、ref-02.jpg、ref-03.jpgなど。これにより、後で調整が必要な場合に、トレーニングセットにどの画像があるかを追跡しやすくなります。
ステップ3:AIキャラクターをトレーニングする
参照写真の準備ができたら、トレーニングプロセスを開始できます。キャラクタートレーニングはサーバー側で行われ、画像の数とシステム負荷に応じて2〜4時間かかります。
参照写真をアップロードする
MakeInfluencer.aiにログインし、キャラクタートレーニングツールに移動します。1〜20枚の参照写真をアップロードします。システムは各画像を検証して、技術要件を満たしていることを確認します。
画像が拒否された場合、システムは具体的なフィードバックを提供します:解像度が低すぎる、顔が検出されない、ファイル形式がサポートされていないなど。問題を修正して再アップロードしてください。
トレーニング設定を構成する
キャラクター名:AIインフルエンサーの名前を選択します。この名前は、生成プロンプトと管理ツールでキャラクターを参照するために使用されます。
トレーニングモード:標準モードはほとんどのユースケースで機能します。上級モードは、スタイル、一貫性、特徴の重み付けに対する正確な制御を必要とするクリエイター向けの微調整オプションを提供します。
スタイル設定:フォトリアリスティック(デフォルト)またはスタイライズド(アニメ、イラスト、3Dレンダー)。インフルエンサーコンテンツにはフォトリアリスティックが推奨されます。
トレーニングコストとクレジット
キャラクタートレーニングはプラットフォームクレジットを使用します。標準的なトレーニング実行(3〜5枚の画像)は、設定に応じて約500〜800クレジットかかります。開始する前にクレジット残高を確認してください。トレーニングが完了すると、トレーニング済みキャラクターでの画像生成には、プロンプトベースの生成と同じコストである標準の生成クレジットを使用します。
トレーニングを開始して進行状況を監視する
「トレーニング開始」をクリックしてプロセスを開始します。システムはジョブをトレーニングキューに追加し、コンピューティングが利用可能になるとすぐに処理を開始します。
ダッシュボードからリアルタイムでトレーニングの進行状況を監視できます。システムが各段階を完了すると、ステータスが更新されます:
- 前処理:画像の検証、顔の検出、データセットの準備。
- モデルトレーニング:ニューラルネットワークトレーニングループを実行してキャラクターを学習。
- 検証:一貫性と品質を検証するためのテスト画像の生成。
- 最終化:トレーニング済みモデルの保存と生成に利用可能にする。
トレーニングは通常2〜4時間で完了します。ログインしたままにする必要はありません。トレーニングが終了すると、システムはメール通知を送信します。
トレーニング結果をレビューする
トレーニングが完了すると、システムはさまざまなポーズと設定でトレーニング済みキャラクターを示す一連の検証画像を生成します。これらを注意深く確認してください:
- 顔の一貫性:すべての検証画像で顔が同じに見えますか?
- 特徴の正確性:特徴的な特性(目、鼻、顎のライン)が正しく保持されていますか?
- スタイルの品質:出力は意図した美学に一致していますか?
結果が良さそうであれば、キャラクターは使用準備ができています。何かがずれている場合(顔の特徴が一貫していない、スタイルが期待に合わない)、調整された設定または異なる参照写真で再トレーニングできます。
ステップ4:トレーニング済みキャラクターでコンテンツを生成する
画像生成でキャラクターを使用する
キャラクターライブラリからトレーニング済みキャラクターを選択し、任意のAIモデルで通常どおり画像を生成します。重要な違い:プロンプトに詳細な顔の説明を書く代わりに、名前でキャラクターを参照します。
プロンプト構造:
[キャラクター名]、[衣装とスタイリング]、[ポーズまたは活動]、
[場所と設定]、[照明とムード]、[カメラアングル]。
例:
Luna、白いオーバーサイズのパーカーと黒いレギンスを着て、
モダンなグレーのソファにあぐらをかいて座っている、窓からの暖かい午後の日光、
居心地の良いアパートのインテリア、やや目線の上から撮影。
AIはトレーニング済みキャラクターの顔の特徴を使用し、説明したシーン、衣装、ポーズに適応させます。顔は一貫性を保ちながら、他のすべてが変わります。
クロスモデル一貫性
キャラクタートレーニングの最大の利点の1つは、クロスモデルサポートです。再トレーニングすることなく、トレーニング済みキャラクターを複数のAI画像モデルで使用できます:
- Nano Banana Pro:フォトリアリスティックなInstagramスタイルのコンテンツ
- Seedream:ハイファッションエディトリアルルック
- Qwen 2.0 Pro Edit:キャラクターのアイデンティティを保持したアプリ内画像編集
- GPT Image 1:一般的なコンテンツのバランスの取れた品質
キャラクターは、どのモデルを使用しても同じ顔の特徴を維持します。これにより、一貫性を心配することなく、各コンテンツタイプに適したモデルをマッチングできます。
一貫したビジュアルブランドを維持する
キャラクターで動画を作成する
トレーニング済みキャラクターは、画像モデルと同様に動画生成ツールでも機能します。これには以下が含まれます:
リップシンク動画:スクリプトまたはオーディオファイルをアップロードすると、キャラクターがトーキングヘッド動画としてコンテンツを配信します。顔なしYouTubeチャンネル、製品レビュー、チュートリアル、教育コンテンツに最適です。
画像から動画へ:キャラクターの静止画像を取得し、Veo 3、Sora 2、またはMotion Controlでアニメーション化します。ソーシャルメディアのReels、TikToks、動画広告に最適です。
一貫した動画キャラクター:さまざまな設定でキャラクターをフィーチャーした複数のシーンを生成し、それらを一貫した動画ナラティブに編集します。
AI動画生成ワークフローとAI生成動画コンテンツで収益化する方法についてさらに詳しく学びましょう。
生成された画像を編集して洗練する
すべての生成が最初の試行で完璧であるとは限りません。Qwen 2.0 Pro Editを搭載したアプリ内画像エディターを使用して、キャラクターのアイデンティティを保持しながら出力を洗練します。
一般的な編集:
- 衣装を変更する:画像全体を再生成せずに服を交換
- 背景を調整する:設定と場所を置き換えまたは変更
- ポーズを洗練する:手の位置、体の角度、または顔の表情を微調整
- 不完全さを修正する:生成アーティファクトや不一致を修正
エディターはトレーニング済みキャラクターを理解し、すべての編集を通じて顔の一貫性を保ちます。詳細はAI画像編集ガイドをご覧ください。
ステップ5:コンテンツライブラリを構築する
キャラクターがトレーニングされ、ワークフローが設定されたら、さまざまなコンテキストでAIインフルエンサーを紹介する多様なコンテンツライブラリの構築に焦点を当てます。
ソーシャルグロースのためのコンテンツの多様性
視聴者は多様性とエンゲージします。一貫したキャラクターでも、フォロワーの興味を維持し、アルゴリズムが求めるものを提供するには、多様なコンテンツタイプが必要です。
ポートレートとセルフィースタイルの投稿:クローズアップショット、さまざまな表情、カジュアルな衣装。これらはInstagramとTwitterで好成績を収めます。
ライフスタイルとアクティビティコンテンツ:キャラクターがワークアウト、料理、旅行、ゲーム、読書をしている様子。共感できる日常生活コンテンツ。
ファッションとスタイルショーケース:衣装の変更、季節のルック、トレンドへの参加。ファッションと美容ニッチで高いエンゲージメント。
ブランドとスポンサーコンテンツ:製品配置、ブランド統合、アフィリエイトプロモーション。AIインフルエンサーを使用したアフィリエイトマーケティングのガイドをご覧ください。
舞台裏とメタコンテンツ:作成プロセスを示し、AIキャラクターであることについて話します。驚くほどエンゲージメントがあり、会話のきっかけになります。
効率のためのバッチ生成
一度に1つの画像ではなく、バッチでコンテンツを生成します。さまざまな衣装、設定、シナリオをカバーする20〜30のプロンプトをキューに入れます。それらをすべて1つのセッションで処理し、次の1〜2週間にわたって投稿をスケジュールします。
バッチ生成は高速で、クレジットをより効率的に使用し、コンテンツカレンダーの先を進むのに役立ちます。
品質管理を維持する
トレーニング済みキャラクターでも、すべての生成が投稿に値するわけではありません。すべての出力をレビューし、最高の作品のみを公開してください。一貫したキャラクターと一貫性のない品質は、依然として弱いブランドです。
以下を探してください:
- クリーンな顔の特徴:生成アーティファクト、ぼやけ、歪みがない
- 自然なプロポーション:手、腕、体がリアルに見える
- 適切な照明:シーンが明るく、視覚的に魅力的
- ブランドに沿った美学:画像が全体的なスタイルとバイブに一致
基準を満たさないものは削除または再生成します。長期的には、量よりも質が常に勝ちます。
ステップ6:AIインフルエンサーをスケールして収益化する
一貫したキャラクターと成長するコンテンツライブラリができたら、視聴者の成長と収益化に焦点を当てます。詳細は、AIインフルエンサーで稼ぐ方法の包括的なガイドをご覧ください。
プラットフォーム戦略
Instagram:高品質のポートレートとライフスタイルコンテンツに焦点を当てます。リーチにはReelsを使用し、エンゲージメントには静的投稿を使用します。明確な価値提案と収益化プラットフォームへのリンクでバイオを最適化します。
TikTok:短編動画コンテンツを優先します。リップシンクを使用してトーキング動画を作成し、Motion ControlまたはSora 2を使用してダイナミックな視覚コンテンツを作成します。アルゴリズムの恩恵を最大限に受けるために毎日投稿します。
Twitter/X:静的画像、短い動画、パーソナリティ駆動型のテキスト投稿の組み合わせを共有します。AIインフルエンサーは、トレンドとコミュニティの会話にエンゲージするとTwitterで驚くほど好成績を収めます。
YouTube:より深い収益化のための長編コンテンツ。リップシンクを使用して、ニッチなトピックに関する5〜10分の動画を作成します。YouTube AdSense、スポンサーシップ、アフィリエイトリンクは、ほとんどのプラットフォームよりも視聴ごとに高い収益を提供します。
収益化の道筋
クリエイタープラットフォーム:独占コンテンツを含むプレミアムサブスクリプションフィードを開始します。AIインフルエンサーは、人間のクリエイターが苦労する規模でサブスクライバー向けのカスタムコンテンツを生成できます。
アフィリエイトマーケティング:アフィリエイトリンクでニッチに関連する製品を宣伝します。AIインフルエンサーは、製品を購入または物理的に扱う必要なく、本物らしい製品コンテンツを作成することに優れています。
デジタル製品:プリセット、テンプレート、またはデジタルダウンロードを販売します。キャラクターは、デジタルファッションをモデル化したり、デザイン作品を紹介したり、教育製品を宣伝したりできます。
法的および倫理的考慮事項
AI生成コンテンツが主流になるにつれて、透明性がますます重要になっています。現在、ほとんどのプラットフォームでは、クリエイターがAI生成ペルソナにラベルを付けることを要求しています。
開示のベストプラクティス:
- バイオで、インフルエンサーがAI生成であることを明確に述べます
- 実在の人物になりすましたり、視聴者を欺いたりしないでください
- プラットフォーム固有のAIコンテンツポリシーとラベリング要件に従ってください
- 知的財産を尊重し、許可なく著作権で保護された画像でトレーニングしないでください
視聴者との信頼を築くことは、より良い長期的なエンゲージメントと収益化につながります。透明性は成長を妨げません -- 最も成功したAIインフルエンサーの多くは、その性質についてオープンです。
トレーニング済みキャラクターからの実際の収益
一般的なトレーニング問題とその修正方法
良い参照写真を使用しても、トレーニングが常に完璧に進むとは限りません。最も一般的な問題とその解決策を以下に示します。
問題:生成間で一貫性のない顔の特徴
原因:参照写真の多様性が不十分、または参照写真が互いにあまりにも異なる。
修正:複数のアングル(正面、四分の三、プロフィール)と表情(ニュートラル、笑顔)をカバーする5〜10枚の写真で再トレーニングします。すべての参照写真が同じ人物のもので、類似した照明条件下で撮影されていることを確認してください。
問題:AIがキャラクターの民族性または肌の色調を変更する
原因:参照写真の照明が一貫していないため、画像間で肌の色調が異なって見える。
修正:一貫した均一な照明の参照写真を使用します。露出またはホワイトバランスの問題により肌の色調が著しく明るくまたは暗く見える写真を避けてください。
問題:生成された画像が過度にスムーズまたは人工的に見える
原因:参照写真がトレーニング前に heavily filtered または編集されていた。
修正:自然で未編集の写真で再トレーニングします。AIはトレーニングデータから学習します。filtered な画像でトレーニングすると、すべての生成でその人工的なルックを再現します。
問題:トレーニングが失敗またはスタックする
原因:1つ以上の参照写真が技術要件を満たしていない(解像度が低すぎる、顔が検出されない、ファイルが破損している)。
修正:特定のエラーメッセージについてトレーニングログを確認します。問題のある画像を再アップロードまたは置き換えて、トレーニングを再開します。
問題:異なるAIモデル間でキャラクターが異なって見える
原因:一部の古いまたはあまり高度でないモデルは、キャラクター一貫性サポートが弱い。
修正:強力なキャラクターサポートを持つモデルにこだわってください:Nano Banana Pro、Seedream、GPT Image 1。一貫性が重要な場合は、古いまたは実験的なモデルを避けてください。
高度なトレーニングテクニック
基本的なキャラクタートレーニングをマスターしたら、これらの高度なテクニックにより、さらに多くの制御と柔軟性が得られます。
スタイル制御のための多段階トレーニング
キャラクターを2段階でトレーニングします:まず顔のアイデンティティのため、次に特定の芸術的スタイルのために微調整します。これにより、特定の美学(例:Instagramモデル、エディトリアルファッション、アニメ風)に一致しながらアイデンティティを維持するキャラクターが得られます。
より良いカバレッジのためのデータセット拡張
1〜2枚の参照写真しかないが、より良い一貫性が必要な場合は、初期のトレーニング済みモデルを使用して追加のトレーニング画像を生成します。それらの生成された画像を2回目のトレーニング実行で補足的なトレーニングデータとして使用します。これにより、より多くのオリジナル写真を必要とせずにデータセットが拡張されます。
ユニークな顔のためのキャラクターミキシング
2つの別々のキャラクターをトレーニングし、プロンプトの重み付けまたはモデルマージングテクニックを使用して特徴をブレンドします。これにより、両方のソースキャラクターからの特性を組み合わせた全く新しい顔が作成されます。実験的ですが、ユニークなインフルエンサーを作成するのに強力です。
よくある質問
1枚の写真からキャラクターをトレーニングできますか?
はい。単一画像トレーニングは機能しますが、柔軟性は限定的です。AIは、参照写真と類似したポーズとアングルでキャラクターを生成できますが、極端なアングルの変化や異常な表情には苦労します。最良の結果を得るには、複数のアングルをカバーする少なくとも3〜5枚の写真を使用してください。
キャラクタートレーニングにはどのくらいかかりますか?
標準的なトレーニングは、参照写真の数とシステム負荷に応じて2〜4時間かかります。トレーニングが完了すると、メール通知を受け取ります。スタイルの微調整を含む高度なトレーニングは4〜6時間かかる場合があります。
結果に満足できない場合、キャラクターを再トレーニングできますか?
はい。必要に応じて何度でも再トレーニングできます。各トレーニング実行はクレジットを使用するため、不要な再トレーニングコストを避けるために、開始する前に参照写真を注意深く確認してください。
異なるAIモデルのためにキャラクターを再トレーニングする必要がありますか?
いいえ。キャラクターがトレーニングされると、再トレーニングなしですべてのサポートされているAIモデルで機能します。Nano Banana Pro、Seedream、GPT Image 1、および動画ツールで同じキャラクターを使用します。
1つのアカウントで複数のキャラクターをトレーニングできますか?
トレーニング後に参照写真を削除するとどうなりますか?
何も起こりません。トレーニング済みキャラクターモデルは、元の参照写真から独立しています。トレーニングが完了したら、デバイスから参照写真を削除できます。AIは、元の画像ではなく、トレーニング済みモデルのみを必要とします。
トレーニング済みAIキャラクターを販売またはライセンスできますか?
はい、トレーニングで使用された参照写真の権利を所有している限り。ブランド使用のためにキャラクターをライセンスしたり、キャラクターで生成されたカスタムコンテンツを販売したり、クライアントにキャラクターデザインサービスを提供したりできます。参照写真がオリジナルの生成物、個人写真、または適切にライセンスされた画像であることを確認してください。
ゼロから再トレーニングせずにトレーニング後にキャラクターを更新する方法はありますか?
はい。インクリメンタルトレーニングを使用して、最初からやり直すことなく特定の特徴を調整したり、新しい参照アングルを追加したりできます。これは、完全な再トレーニングよりも高速で安価です。インクリメンタルトレーニングは、高度なトレーニング設定で利用できます。
今日からAIインフルエンサーの作成を開始
参照写真からAIインフルエンサーをトレーニングすることは、完璧なキャラクターの一貫性を達成する最も信頼できる方法です。1〜20枚の画像と数時間のトレーニング時間で、すべてのコンテンツタイプとプラットフォームにわたってパフォーマンスを発揮する認識可能なデジタルペルソナを構築できます。
MakeInfluencer.aiは、AIインフルエンサーをトレーニング、生成、収益化するために必要なすべてを提供します。アカウントを作成し、参照写真をアップロードして、今日最初のキャラクターをローンチしましょう。